
 ModalModalは、インフラ管理なしで弾力的なクラウド実行を必要とするAI、データ、Python、GPU、バッチ、サンドボックス、ノートブック、推論ワークロードのためのサーバーレス計算プラットフォームです。
RunPod
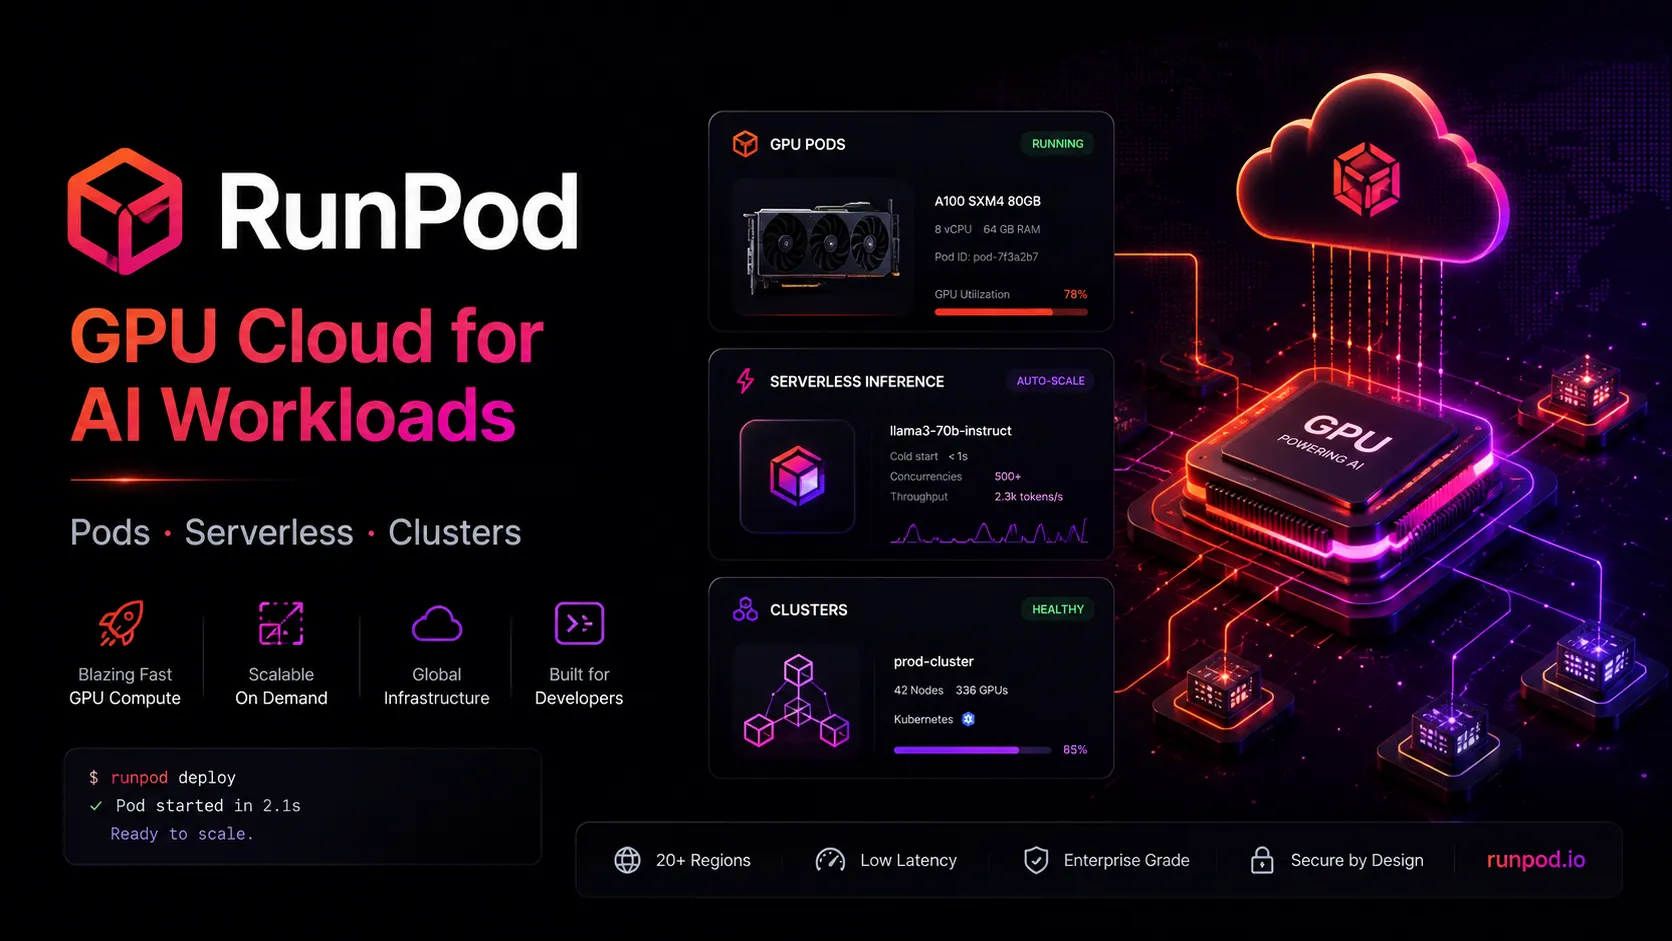
RunPodは、対話的なGPUインスタンス、サーバーレス推論エンドポイント、パブリックモデルAPI、マルチノードクラスターを実行するための、GPUに特化したAI開発者向けクラウドです。
情報確認日: 2026年6月16日 ·出典を見る
ツール情報
- 種類
- 開発ワークフロー
- 対応プラットフォーム
- Browser, API, Python SDK, Docker, JupyterLab, SSH, VS Code, Cursor, GitHub, Linux, CUDA, vLLM, ComfyUI, RunPod Serverless, RunPod Pods, RunPod Clusters
- 無料プラン
- 非対応
- オープンソース
- 非対応
- 独自の API キーを使用
- 対応
- ローカルモデル
- 対応
概要
適した用途
- ハードウェアを購入せずにオンデマンドGPUを必要とするAI開発者
- LLM、画像、音声、動画の推論エンドポイントをデプロイするチーム
- ComfyUI、Stable Diffusion、vLLM、Ollama、ノートブック、またはカスタムDockerワークロードを実行する開発者
- 予約容量を契約する前にAIプロダクトのプロトタイプを作成したいスタートアップ
- 対話的な開発用Podと本番用サーバーレスエンドポイントの両方を必要とするチーム
強み
- AIトレーニング、ファインチューニング、推論、ノートブック、画像・動画生成ワークフローを幅広くカバーするGPUラインナップ。
- 対話的なGPU Podとオートスケーリング対応のサーバーレスGPUエンドポイントの両方をサポート。
- 秒単位の課金や従量課金オプションにより、変動のあるAIワークロードで高い費用対効果を発揮。
- テンプレート、JupyterLab、SSH、VS Code/Cursorアクセス、Dockerサポートにより、開発者にとって実用的。
- パブリックエンドポイントとHubテンプレートにより、一般的なAIモデルワークフローのセットアップ時間を短縮。
制約とトレードオフ
- AI IDE、自動補完アシスタント、またはコードレビューボットを探している開発者
- GPU計算を必要としないシンプルなウェブアプリ
- コンテナやエンドポイントの設定なしで、完全に管理されたモデルAPIを必要とするチーム
- 長時間稼働するGPUワークロードのコスト管理体制が整っていない組織
- Windows Pod、UDPサポート、またはPod内でのDocker Composeを必要とするワークロード
- それ自体はAIコードエディタやコーディングアシスタントではありません。
- GPUの可用性、価格、パフォーマンスは、リージョン、クラウドの種類、GPUクラスによって異なる場合があります。
- サーバーレス推論では、コールドスタート、モデルのロード、キュー、ワーカーの慎重な設定が必要です。
- Podを利用する場合、コンテナ、ストレージ、ポート、認証情報、およびシャットダウンの管理をユーザー自身で行う必要があります。
- 監視を行わないと、ストレージ、アイドル状態のリソース、長時間稼働のGPUによって予期せぬコストが発生する可能性があります。
使い始める
料金と利用上限
料金は $0.27
PodsFrom $0.27 / GPU/時間
開発や長時間稼働のワークロード向けの専用GPUインスタンス。公開価格に基づいたRTX A5000の開始価格を表示しています。
ServerlessFrom $0.58 / GPU/時間
推論エンドポイント向けの従量課金制サーバーレスGPUワーカー。16GB GPUクラスの公開開始価格を表示しています。
ClustersFrom $1.79 / GPU/時間
分散AIワークロード向けのマルチノードGPUクラスター。一部のGPUは営業担当への問い合わせが必要です。
Reserved ClustersContact sales
可用性が保証された専用GPUクラスター。カスタム構成、SLAによる稼働率保証、エンタープライズ割引が適用されます。
StorageFrom $0.05 / GB/月
コンテナディスク、ボリュームディスク、ネットワークストレージ、ハイパフォーマンスストレージなどの永続ストレージオプション。
Public EndpointsUsage-based
画像、音声、言語、動画ワークロード向けに事前デプロイされたAIモデルAPI。
EnterpriseCustom
カスタム容量、コンプライアンス対応、サポート、予約、大規模GPUインフラ契約。
料金確認日: 2026年6月16日 · 利用上限、モデルの料金、サブスクリプションは別々に請求される場合があります。
機能と詳細
GPU Pod
- オンデマンドのGPUおよびCPUインスタンス
- SSH、JupyterLab、ウェブプロキシ、VS Code/Cursorによるアクセス
- 一般的なAI環境向けのテンプレート
- カスタムDockerコンテナのサポート
サーバーレス推論
- サーバーレスGPUエンドポイント
- 秒単位のワーカー課金
- アイドル時の自動シャットダウンを備えたオートスケーリング
- ハンドラー関数とロードバランシングエンドポイント
AIワークロード対応
- モデルのトレーニングとファインチューニング
- LLM推論と vLLM ワークロード
- ComfyUIと画像生成ワークフロー
- AIエージェントと計算負荷の高いタスク
開発者ツール
- Python SDKおよびAPIサポート
- Dockerイメージによるデプロイ
- サーバーレスワーカー向けのGitHubリポジトリ連携
- テンプレート、Hub、再利用可能な構成
ストレージとデータ
- コンテナディスクストレージ
- 永続ボリュームディスク
- ネットワークボリューム
- S3互換のストレージAPI
スケールと運用
- 小規模な推論用カードからH100、H200、B200クラスまでのGPUタイプ
- Secure CloudおよびCommunity Cloudの選択肢
- インスタントクラスターと予約クラスター
- ログ、メトリクス、エンドポイント設定、ワーカーのデバッグ
RunPodが選ばれる理由
RunPodは、GPUリソースの確保がボトルネックとなっている場合に最も真価を発揮します。高価なハードウェアを自前で購入したり、早い段階から大手クラウドとエンタープライズ契約の交渉をしたりする代わりに、開発者は実験用のGPU Podを即座に起動し、推論をサーバーレスエンドポイントに移行し、利用状況が予測可能になった段階でクラスターや予約容量によってワークロードをスケールさせることができます。
このプラットフォームは、対話的な開発と本番環境レベルのワークロードの両方をサポートしているため、AI開発者にとって非常に実用的です。研究者や個人開発者はJupyterLabを開いたり、VS CodeやCursorをPodに接続したりして作業でき、プロダクトチームはモデルをAPIエンドポイントの背後にデプロイし、リクエストを処理した分だけ料金を支払う運用が可能です。
主なワークフロー
一般的なRunPodのワークフローは、まずPodの作成から始まります。開発者はGPU、ストレージタイプ、リージョン、テンプレートを選択し、SSH、JupyterLab、ウェブプロキシ、またはVS Code/Cursor経由で接続します。これは、ノートブック、モデルの実験、ComfyUI、ファインチューニング、単発の計算ジョブを実行するための最短ルートです。
本番環境での推論については、サーバーレス(Serverless)へと移行します。チームはハンドラー関数またはHTTPサーバーを記述し、Dockerイメージにパッケージ化してエンドポイントにデプロイします。その後、ワーカー、スケーリング、キャッシュ、コールドスタートの挙動、コスト制限を設定します。これは長時間稼働させるPodとは考え方が異なり、許容可能なレイテンシを維持しつつ、アイドル時のコストを低く抑えることが目的となります。
大規模なトレーニングや分散ワークロードの場合は、クラスターや予約容量が重要になります。これらは、すでに利用パターンを把握しており、より予測可能なGPUの可用性を必要とするチームに適しています。
向いている用途
RunPodは、LLM推論、画像生成、動画生成、音声処理、ComfyUIワークフロー、Stable Diffusionの実験、ファインチューニング、モデル評価、バッチ処理、AIエージェント、ノートブック、カスタムCUDAワークロードに適しています。
また、プロトタイプから本番環境への橋渡しを必要とするAIプロダクト開発者にとっても有用です。最初はノートブックやPodでの実験から始め、APIの形状、レイテンシ目標、コスト構造が明確になった段階で、コンテナ化されたエンドポイントへと移行できます。
他のサービスとの比較
Modalと比較すると、RunPodはよりGPUインフラそのものに焦点を当てています。ModalはPythonネイティブなサーバーレス関数や開発体験に優れていますが、RunPodはGPU Pod、テンプレート、コンテナ、サーバーレスエンドポイント、パブリックエンドポイント、クラスターをより直接的に制御できます。
Replicateと比較すると、RunPodはインフラの制御自由度が高くなります。ReplicateはモデルAPIのパッケージ化と共有が容易ですが、GPUタイプ、ストレージ、コンテナ、エンドポイント設定、開発環境の詳細を自ら選択したい場合はRunPodが適しています。
Vast.aiと比較すると、RunPodは開発者向けに製品化が進んでいる印象を与えます。Vast.aiはマーケットプレイス形式の低価格なGPUアクセスが魅力ですが、RunPodはPod、サーバーレス、テンプレート、API、エンドポイント、エンタープライズ向け容量といった明確なプラットフォーム層を提供しています。
Northflankと比較すると、RunPodはより専門化されています。NorthflankはGPUをサポートする汎用的なアプリデプロイプラットフォームですが、RunPodは主にモデル開発と推論のためのAI GPUクラウドです。
推奨される構成
実験目的の場合は、必要なスタックがあらかじめ含まれているテンプレートを使用してPodを開始してください。これにより、CUDA、PyTorch、JupyterLab、モデルツールのインストール時間を短縮できます。Podを削除してもデータを保持したい場合はネットワークボリュームを使用し、不要な支出を避けるためにアイドル状態のPodは積極的に停止してください。
推論については、モデルのメモリ使用量、起動時間、平均リクエスト時間、トラフィックの傾向を把握した後にサーバーレスを選択してください。大規模なモデルではコールドスタートがユーザー体験を損なう可能性があるため、サーバーレスが安価で高速であると判断する前に、キャッシュされたモデル、FlashBoot、アクティブワーカー、ロードバランシングエンドポイントをテストすることをお勧めします。
チームで利用する場合は、可能な限り開発用と本番用のカウントまたはコストセンターを分離してください。ノートブック、実験、本番エンドポイントが同じ請求画面を共有していると、GPUコストの管理ミスが発生しやすくなります。
導入時の注意点
ローカルGPUから移行するチームは、まずRunPodのテンプレートやカスタムコンテナ内でローカル環境を再現することから始めてください。最初の目標は本番デプロイではなく、再現性の確保です。モデルがPod上で安定して動作するようになったら、そのワークロードが長時間稼働のPod、サーバーレス、クラスターのどれに適しているかを評価してください。
従来のクラウドGPUインスタンスから移行するチームは、GPUの時給だけでなく、トータルコストモデルを比較してください。ストレージ、アイドル時間、コールドスタート、ワーカー設定、リージョンの可用性、データ転送、運用上の複雑さは、公表されているGPU価格と同じくらい重要になる場合があります。
マネージドモデルAPIから移行するチームは、制御権が増える一方で責任も増えることを覚悟してください。RunPodはカスタムモデルにおいて安価で柔軟な選択肢となりますが、コンテナ化、エンドポイント設定、モニタリング、セキュリティ確認、コスト管理を自ら行う必要があります。
対応モデルとデータプライバシー
対応モデル
- Llama
- DeepSeek
- Qwen
- FLUX
- Stable Diffusion
- Whisper
- WAN
- Kling
- Sora
- IBM Granite
- Seedream
- Minimax
プライバシーとデータの取り扱い
RunPodはSecure CloudとCommunity Cloudのインフラオプションを提供しており、ドキュメントには欧州データセンターリージョンで処理されるデータのGDPR対応、およびセキュリティとコンプライアンスのガイダンスが記載されています。ユーザーがカスタムコンテナ、モデル、データセット、APIキー、ボリュームを運用することが多いため、機密データを処理する前に、Podのタイプ、データセンター、ストレージの場所、シークレットの取り扱い、ログ、イメージの出所、エンドポイントの公開設定、およびコンプライアンス要件を確認する必要があります。
ガイド、レビュー、トラブル対処
公開済みのガイドはまだありません。上記の公式ドキュメントをご参照ください。
製品の更新情報
確認済みの製品更新はまだありません。フォローすると関連する新着情報を「保存済み」で確認できます。
関連コンテンツの更新履歴を見る代替ツール
ModalModalは、インフラ管理なしで弾力的なクラウド実行を必要とするAI、データ、Python、GPU、バッチ、サンドボックス、ノートブック、推論ワークロードのためのサーバーレス計算プラットフォームです。 ReplicateReplicateは、GPUインフラを運用することなく、マネージドな推論とモデルデプロイを行いたい開発者のためのAPIファーストなAIモデルプラットフォームです。
 NorthflankNorthflankは、Northflank Cloudまたは顧客所有のクラウドインフラ上で、本番ワークロード、AIインフラ、データベース、ジョブ、プレビュー環境をデプロイするためのフルスタック開発者プラットフォームおよびPaaSです。
 Together AITogether AIは、完結したAIコードエディタではなく、ホストされたオープンモデルの推論、ファインチューニング、評価、およびGPUベースのデプロイを求めるチームのための開発者インフラプラットフォームです。
 Fal AIfal.aiは、ホスト型AIモデルAPIの呼び出しや、サーバーレスGPUインフラへのカスタムモデルのデプロイを可能にする、開発者優先の生成メディア・インフラ・プラットフォームです。
 Fly.ioコンテナデプロイ、グローバル分散仮想マシン、プログラム可能なネットワークを組み合わせ、従来のPaaSよりも高いインフラ制御能力を提供する開発者向けクラウドプラットフォーム。
出典と確認記録
確認日は当サイトが情報を確認した日です。製品のリリース日は上に別途表示しています。
公式サイト公式料金ページRunPodドキュメント概要PodドキュメントPod料金ドキュメントサーバーレスドキュメントサーバーレス料金ドキュメントサーバーレスエンドポイントドキュメントAPIリファレンスGPUタイプのリファレンスセキュリティとコンプライアンスのドキュメントRunPodコンプライアンスページ
掲載情報の修正履歴
RunPod公式サイト、料金ページ、ドキュメント概要、Pod、サーバーレス、エンドポイント、API、GPUタイプ、セキュリティ/コンプライアンスの各ソースに基づき、初期ディレクトリ項目を作成。