
 ReplicateReplicateは、GPUインフラを運用することなく、マネージドな推論とモデルデプロイを行いたい開発者のためのAPIファーストなAIモデルプラットフォームです。
Fal AI
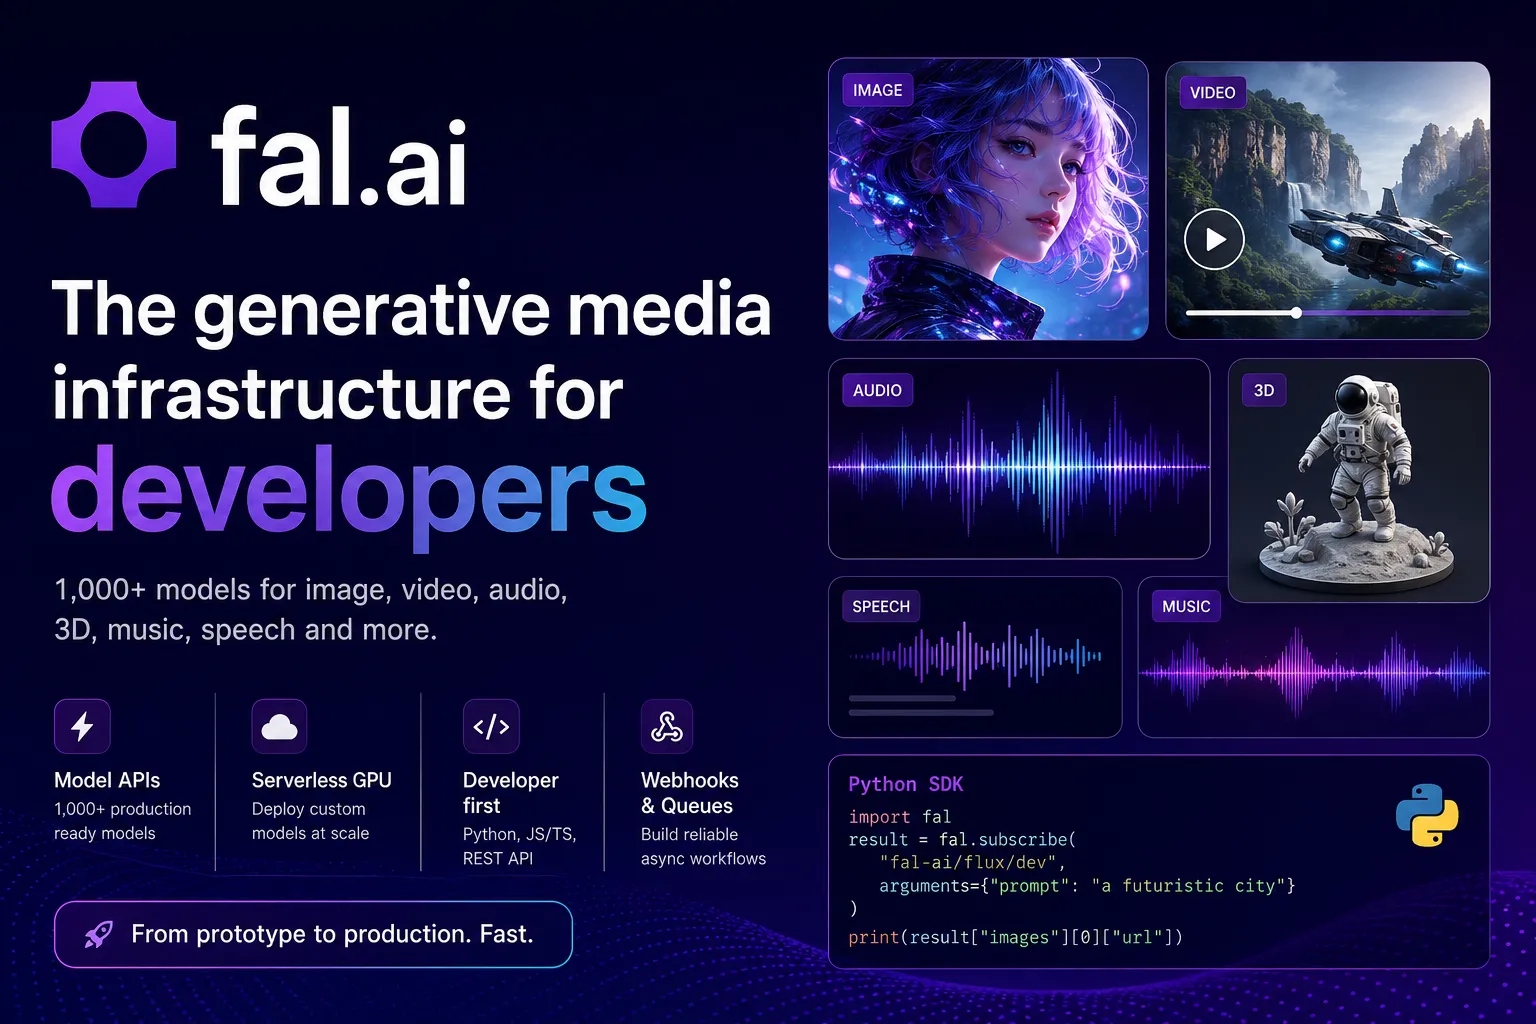
fal.aiは、ホスト型AIモデルAPIの呼び出しや、サーバーレスGPUインフラへのカスタムモデルのデプロイを可能にする、開発者優先の生成メディア・インフラ・プラットフォームです。
情報確認日: 2026年6月16日 ·出典を見る
ツール情報
- 種類
- 開発ワークフロー
- 対応プラットフォーム
- Browser, API, Python, JavaScript, TypeScript, Node.js, React Native, REST, Docker, Serverless GPU, H100, H200, B200, B300, A100, ComfyUI
- 無料プラン
- 対応
- オープンソース
- 非対応
- 独自の API キーを使用
- 非対応
- ローカルモデル
- 非対応
概要
適した用途
- 高速な画像、動画、音声、3D生成APIを必要とするAIアプリ
- Web、モバイル、バックエンド製品に生成メディア機能を追加する開発者
- カスタムインフラを構築する前にホスト型モデルAPIを比較検討したいチーム
- プライベートまたはファインチューニング済みのメディアモデルをデプロイするAIスタートアップ
- 非同期キュー、Webhook、スケーラブルな推論パイプラインを必要とする製品
- プライベートホスティング、専用インフラ、SLAサポートを必要とする企業
強み
- 画像、動画、音声、スピーチ、音楽、3Dモデルを一つのAPIで必要とする生成メディアアプリに最適です。
- プレイグラウンドでのテストから、Python、JS/TS、RESTを用いた本番API統合までが迅速です。
- サーバーレスGPUモデルにより、GPUのオートスケーリングを直接管理せずにカスタムモデルをデプロイできます。
- キュー、ストリーミング、Webhookパターンが、実行時間の長い動画生成や学習ワークロードに実用的です。
- プライベートホスティング、専用インフラ、SSO、SLAなど、エンタープライズ向けのオプションが充実しています。
制約とトレードオフ
- AIコードエディタやIDE拡張機能を探している開発者
- テキストLLMチャットやコード補完のみを必要とするチーム
- クラウドに依存しない完全ローカルなモデル実行環境を求めるユーザー
- モデル推論ではなく、単純な静的ホスティングや汎用アプリのデプロイを必要とするプロジェクト
- プロンプトやメディア、モデルの入出力を外部のAIインフラプロバイダーに送信できないアプリケーション
- これ自体はAI IDEやコードエディタ、コーディングアシスタントではありません。
- モデルの料金は、エンドポイント、出力サイズ、長さ、生成設定によって大きく異なります。
- 現在のドキュメントでは、サーバーレスのカスタムデプロイはエンタープライズ向けに制限されています。
- 実行時間の長いメディア生成には、アプリ側でキュー、Webhook、リトライ、コスト見積もりのロジックを組む必要があります。
- 本番利用の前に、モデル固有のライセンス、安全性、プライバシー、出力権利の制約を確認する必要があります。
使い始める
料金と利用上限
無料プランあり
Free Tier$0
fal.aiは導入用の無料枠を提供しています。含まれるクレジットを超えた利用分は、モデルの出力または計算リソースの使用量に応じて請求されます。
Model APIsUsage-based
構築済みモデルエンドポイントは、画像1枚、1メガピクセル、動画1秒、または動画1本といった出力単位で課金されます。
Image ModelsFrom $0.02 / メガピクセルあたり
公開料金の例:Qwen画像生成は1メガピクセルあたり$0.02、一部の画像モデルは1枚あたり約$0.03〜$0.04です。
Video ModelsFrom $0.05 / 秒あたり
公開料金の例:Wan 2.5は出力1秒あたり$0.05、Kling 2.5 Turbo Proは1秒あたり$0.07、Veo 3は1秒あたり$0.40です。
Serverless & ComputeFrom $1.89 / GPU/時間
カスタムデプロイはGPUインフラ上で実行可能で、H100の料金は1時間あたり$1.89からと表示されています。
EnterpriseCustom
カスタムモデル、専用サーバーレスインフラ、SLA保証、プライベートモデルホスティング、SSO、ユーザー管理、エンタープライズサポートが含まれます。
料金確認日: 2026年6月16日 · 利用上限、モデルの料金、サブスクリプションは別々に請求される場合があります。
機能と詳細
モデルAPI
- 最適化された1,000以上のモデルエンドポイント
- 画像、動画、音声、音楽、スピーチ、3D、マルチモーダルモデル
- ホスト型およびカスタムエンドポイント用の統合API
- モデルページでのプレイグラウンド、スキーマ、料金、コード例の提供
サーバーレスGPU
- カスタムAIモデルとパイプラインのデプロイ
- ゼロから数千のGPUまで自動スケーリング
- Pythonクラスベースのアプリデプロイ
- マシンタイプ別の秒単位ランナー課金
開発者向けSDK
- Pythonクライアント
- JavaScriptおよびTypeScriptクライアント
- REST APIアクセス
- 迅速な統合のためのcURLサンプル
推論ワークフロー
- 同期推論
- キューベースの非同期推論
- ストリーミング更新
- 長時間ジョブ向けのWebhookコールバック
カスタムモデルホスティング
- プライベートモデルエンドポイント
- 独自の重み(Weights)の持ち込み
- LoRAおよびファインチューニング済みモデルのワークフロー
- ComfyUIサーバーレスAPIパターン
エンタープライズ規模
- SOC 2準拠
- シングルサインオン(SSO)
- プライベートエンドポイント
- 利用状況分析と優先サポート
fal.aiが選ばれる理由
fal.aiは、単一のモデルAPIではなく、生成メディアのための包括的なインフラを必要とする製品に最適です。現在のAIアプリの多くは、画像生成、動画生成、編集、アップスケーリング、背景削除、音声、音楽、効果音、3D、LoRAワークフロー、カスタムパイプラインの組み合わせを必要としています。fal.aiは、これらのワークフローをプレイグラウンド、スキーマ、料金体系、サンプルコード、そして本番環境向けの推論パターンを備えた開発者用APIとしてパッケージ化しています。
最大の利点は、統合までの速さです。開発者はブラウザ上でモデルをテストし、PythonやJavaScriptのコードをコピーしてAPIキーで呼び出すことができます。トラフィックの増加に合わせて、キュー、Webhook、プライベートエンドポイント、またはカスタムのサーバーレスデプロイへと段階的に移行することが可能です。
主なワークフロー
最もシンプルなワークフローは「Model APIs」から始まります。マーケットプレイスからモデルを選択し、プレイグラウンドでテストしてコード例をコピーし、Pythonクライアント、JavaScriptクライアント、REST API、またはcURLを使用してバックエンドやアプリから呼び出します。インフラ構築の手間が省け、モデルの出力に基づいた課金となるため、ほとんどのチームにとって最適なエントリーポイントとなります。
動画生成や学習、複雑なメディアパイプラインなど、実行時間の長いジョブには「非同期推論」が適しています。アプリがリクエストを送信し、キューの状態を追跡し、進捗やログを受け取り、準備ができたら結果を取得します。モデルが出力を生成している間、ユーザー向けの接続を維持し続ける必要がないため、Webhookの活用が重要になります。
独自のモデルや特殊なパイプラインには「fal Serverless」が次のステップとなります。Pythonでアプリを記述し、ハードウェア要件を定義し、モデルの重みやランタイムの挙動を制御できます。プロビジョニング、スケーリング、ネットワーク、オブザーバビリティ(観測可能性)はfal側が処理します。
向いている用途
fal.aiは、メディアを生成または変換する製品に適しています。AI画像エディタ、アバター作成アプリ、動画生成ツール、クリエイティブスイート、広告生成プラットフォーム、EC向けメディアツール、音楽・効果音ジェネレーター、音声製品、3Dアセットワークフロー、ゲームアセットパイプライン、AIデザインツールなどが挙げられます。
また、エージェントによるクリエイティブワークフローにも有用です。画像の生成、アップスケール、背景削除、アニメーション化、音声追加といった複数のエンドポイントを連鎖させ、その結果を保存するといった処理が可能です。コスト見積もり、リトライ、キューイング、結果処理を備えた本番用ワークフローとしてこれらのチェインを扱う場合に、このプラットフォームは真価を発揮します。
他のサービスとの比較
Replicateと比較すると、fal.aiは高パフォーマンスな生成メディア推論と、膨大な本番用モデルAPI群に重点を置いています。Replicateはオープンソースモデルの公開ワークフローにおいてシンプルに感じられるかもしれませんが、速度、モデルの多様性、メディアパイプライン、サーバーレスGPUのスケーリングを重視する場合はfal.aiが魅力的です。
RunPodと比較すると、fal.aiはメディアAPIレイヤーをより抽象化しています。RunPodはGPUポッド、サーバーレスワーカー、インフラの直接制御を求めるチームに適しています。fal.aiは、すぐに呼び出せるモデルや、ホスト型モデルAPIからプライベートなカスタムエンドポイントへのスムーズな移行を求めるチームに適しています。
Modalと比較すると、fal.aiは汎用計算よりもメディアモデルに特化しています。ModalはPythonサーバーレス計算やカスタムインフラロジックに優れていますが、fal.aiは生成メディアのエンドポイント、モデルプレイグラウンド、出力ベースの料金体系、AIメディアワークフローに最適化されています。
OpenAIやGoogleのモデルAPIと比較すると、fal.aiは一つのインターフェースからより幅広いサードパーティ製およびオープンなメディアモデルへのアクセスを提供します。トレードオフとして、各モデルの品質、価格、レイテンシ、安全性、ライセンスを個別に評価する必要があります。
推奨される構成
新規製品の場合は、カスタムインフラをデプロイする前に、まずホスト型の「Model APIs」から始めてください。候補となるモデルを1つか2つ選び、プレイグラウンドで品質とレイテンシをテストし、出力ベースの料金でコストを見積もり、非同期キュー処理を含む小規模な統合を構築します。
本番用アプリでは、早い段階でコスト見積もり機能を実装してください。画像、動画、音声の生成は、解像度、長さ、リトライ回数、バッチサイズが増えると高額になる可能性があります。優れた統合とは、推定コストを表示し、ユーザー入力を検証し、出力制限を設け、失敗や遅延したジョブを適切に処理できるものです。
実行時間の長いジョブには、頻繁なポーリングではなくWebhookを使用してください。Webhookのコールバックと冪等(べきとう)性のあるジョブ処理を組み合わせることで、通知の重複やリトライ、ユーザーによるリロードが二重課金や状態の不整合を引き起こさないようにします。
エンタープライズ導入の場合は、機密性の高いワークフローをプライベートエンドポイントに分離し、独自のコンテンツや顧客データを接続する前に、データ処理、モデルアクセス制御、ユーザー管理、SSOを確認してください。
移行時の注意点
単一のモデルプロバイダーから移行するチームは、まず現在のプロンプト、パラメータ、出力形式、エラー処理をfal.aiのエンドポイントスキーマにマッピングすることから始めてください。モデル名が同じでも挙動が同一であるとは限りません。出力品質、レイテンシ、価格、シード値の挙動、アスペクト比のサポート、セーフティフィルター、後処理の必要性を比較してください。
自社運用のGPUから移行するチームは、どのワークロードが真にカスタムであるべきかを特定してください。汎用的なメディア生成はホスト型Model APIsの方が安価で高速な場合がありますが、独自のファインチューニング、カスタムパイプライン、非公開の重みなどはServerlessに配置するのが適切です。
プロトタイプのノートブックから移行するチームは、リクエスト検証、非同期ジョブの状態管理、Webhook、ストレージ、モデレーション、リトライ制限、コスト上限、モデルのフォールバックなど、本番用のワークフローを形式化してください。fal.aiはGPU管理の負担を大幅に軽減しますが、アプリケーション側には依然として強力な製品レベルの制御が必要です。
対応モデルとデータプライバシー
対応モデル
- GPT Image 2
- Seedance 2.0
- Flux 2
- Kling 3.0
- Veo 3.1
- Nano Banana Pro
- Ideogram 4
- Krea 2
- Wan 2.5
- Kling 2.5 Turbo Pro
- Veo 3
- Ovi
- Seedream V4
- Flux Kontext Pro
- Qwen
- MiniMax Speech-02 HD
- Dia TTS
- Beatoven Music
- Beatoven SFX
- ElevenLabs Music
プライバシーとデータの取り扱い
fal.aiはクラウドホスト型の生成AIメディアプラットフォームです。規約では、サービス提供に必要なライセンスを条件として、顧客が入力データの権利を保持するとされています。エンタープライズ向け資料では、顧客データはfalのモデル学習に使用されないと明記されています。機密性の高いメディアデータを送信する前に、モデル固有の規約、APIサービス規約、計算インフラ規約、プライバシーポリシー、データ保持期間、エンタープライズ設定を確認してください。
ガイド、レビュー、トラブル対処
公開済みのガイドはまだありません。上記の公式ドキュメントをご参照ください。
製品の更新情報
確認済みの製品更新はまだありません。フォローすると関連する新着情報を「保存済み」で確認できます。
関連コンテンツの更新履歴を見る代替ツール
ReplicateReplicateは、GPUインフラを運用することなく、マネージドな推論とモデルデプロイを行いたい開発者のためのAPIファーストなAIモデルプラットフォームです。 RunPodRunPodは、対話的なGPUインスタンス、サーバーレス推論エンドポイント、パブリックモデルAPI、マルチノードクラスターを実行するための、GPUに特化したAI開発者向けクラウドです。
 ModalModalは、インフラ管理なしで弾力的なクラウド実行を必要とするAI、データ、Python、GPU、バッチ、サンドボックス、ノートブック、推論ワークロードのためのサーバーレス計算プラットフォームです。
 Together AITogether AIは、完結したAIコードエディタではなく、ホストされたオープンモデルの推論、ファインチューニング、評価、およびGPUベースのデプロイを求めるチームのための開発者インフラプラットフォームです。
 Hugging Faceモデルやデータセットの探索、アプリのデモ、エージェントライブラリ、推論プロバイダー、本番デプロイをつなぐ、オープンモデルの中心的なエコシステムです。
 Vertex AIVertex AI(現在はGemini Enterprise Agent Platformの一部)は、単体のAIコードエディタではなく、AIアプリケーションの構築と運用を行うためのGoogle Cloudマネージドプラットフォームです。
 Amazon BedrockAmazon Bedrockは、安全なモデル駆動型アプリケーション、エージェント、RAGシステム、およびカスタマイズされた基盤モデルワークフローを構築するエンタープライズおよび開発者向けのAWSマネージド生成AIプラットフォームです。
出典と確認記録
確認日は当サイトが情報を確認した日です。製品のリリース日は上に別途表示しています。
公式サイト公式料金ページドキュメント概要クイックスタートガイドモデルAPI概要推論メソッド ドキュメント非同期推論 ドキュメントWebhook ドキュメントサーバーレス導入ガイドサーバーレス料金ドキュメントプラットフォーム料金APIエンタープライズページfal Python GitHubリポジトリfal JavaScript GitHubリポジトリ利用規約プライバシーポリシー
掲載情報の修正履歴
fal.ai公式サイト、料金、ドキュメント、モデルAPI、サーバーレス、エンタープライズページ、SDKリポジトリ、法的ページに基づき初期エントリを作成。