
 LangChainLangChainは、LLMアプリケーションの構築、デバッグ、評価、デプロイのための開発者向けフレームワークおよびエージェントエンジニアリング・エコシステムです。
DSPy
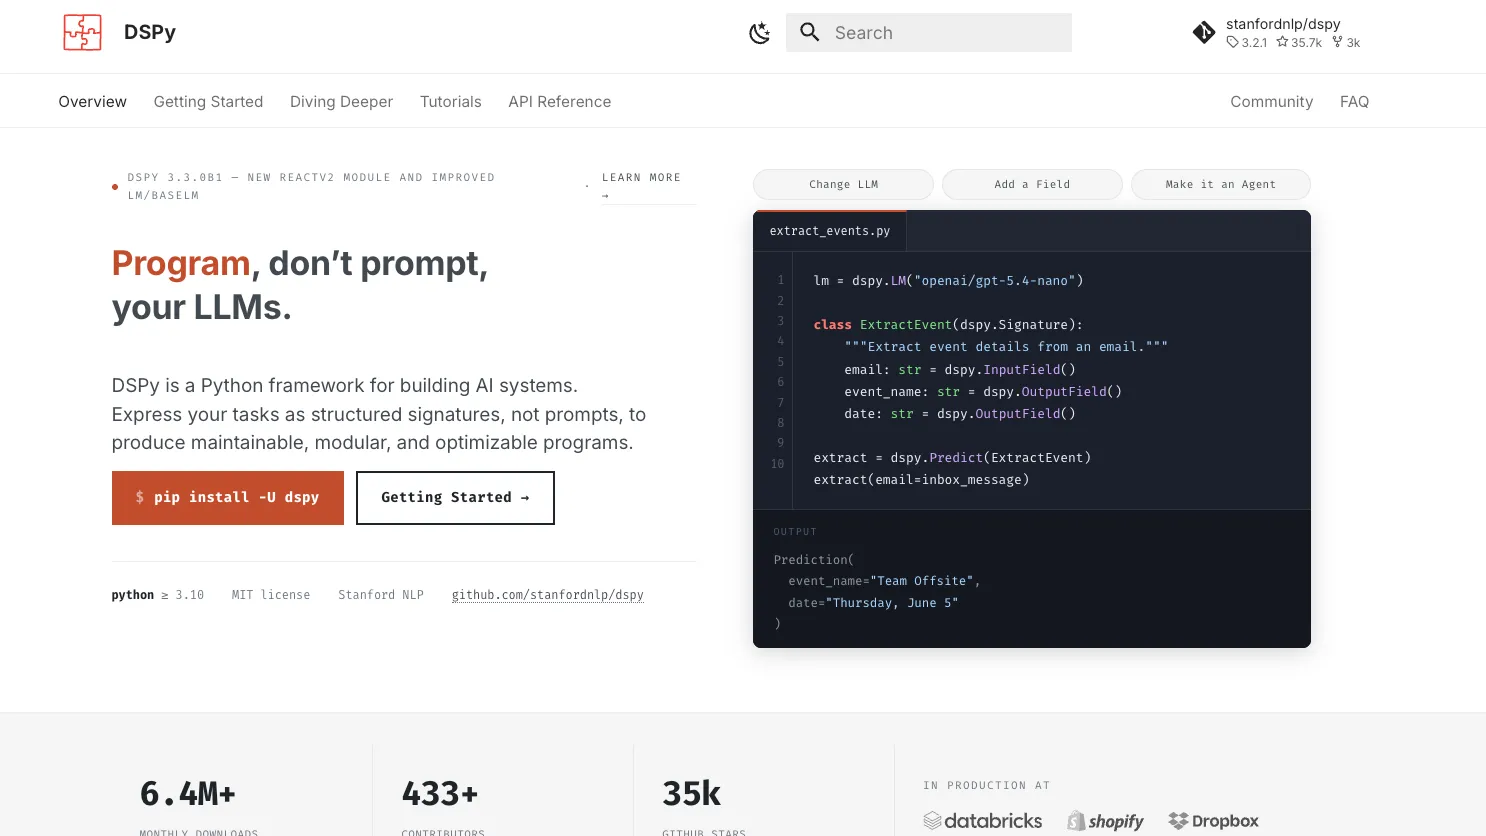
DSPyは、プロンプトテンプレートを手動で管理する代わりに、Pythonでモジュール化・最適化可能な言語モデルプログラムを構築するためのオープンソースフレームワークです。
情報確認日: 2026年7月2日 ·出典を見る
ツール情報
- 種類
- 開発ワークフロー
- 対応プラットフォーム
- Python, Linux, macOS, Windows, Jupyter notebooks, Python services, LiteLLM-compatible providers, API-based model endpoints
- 無料プラン
- 対応
- オープンソース
- 対応
- 独自の API キーを使用
- 対応
- ローカルモデル
- 対応
概要
適した用途
- RAGパイプライン
- LLMを活用したデータ抽出システム
- テキスト分類ワークフロー
- 質問回答(QA)システム
- マルチステップの言語モデルプログラム
- ツールを利用するエージェントループ
- プロンプトおよびデモンストレーションの最適化
- 評価駆動型のLLMアプリケーション開発
- 同じプログラムインターフェースで複数のモデルを比較するチーム
- 研究段階から本番環境へのLLMプロトタイピング
強み
- 脆弱なプロンプト文字列を、構造化されテスト可能なPythonプログラムに置き換えます。
- RAG、抽出、分類、マルチステップ推論、エージェントワークフローに強力に適合します。
- オプティマイザにより、手動のプロンプトエンジニアリングよりも体系的なプロンプト・デモ調整が可能です。
- モデルプロバイダーの柔軟性により、アプリケーション全体を書き直すことなくLLMを切り替えられます。
- オープンソースのMITライセンスであり、研究に裏打ちされた活発なエコシステムがあります。
- 評価メトリクス、再現性、および数値化可能な品質向上を重視するチームに適しています。
制約とトレードオフ
- AIコードエディタを探している開発者
- ターミナル上で動作するコーディングエージェントが必要なチーム
- ノーコードアプリビルダーを探している非技術ユーザー
- 単純な単発のプロンプト実験
- Pythonを使わないビジュアルワークフロー自動化
- 標準機能としてのマネージドな企業向けLLMアプリ管理
- 評価用の例題や品質メトリクスを持たないチーム
- AI IDE、ビジュアルアプリビルダー、またはノーコードのエージェントプラットフォームではありません。
- Pythonのスキルと、単純なプロンプトチェイニングよりも高度なML/評価の考え方が必要です。
- 最適化ワークフローには、例題、メトリクス、および統制された評価データが必要です。
- 本番環境の信頼性は、周囲のアプリ、モデルプロバイダー、検索レイヤー、およびオブザーバビリティスタックに依存します。
- 単発のプロンプトや非常にシンプルなチャットボットのプロトタイプには、抽象化が重すぎると感じられる場合があります。
- シークレット管理、コスト、キャッシュ、トレース、デプロイ、モデルガバナンスは、依然としてユーザーが管理する必要があります。
使い始める
料金と利用上限
無料プランあり
Open Source$0
DSPyはMITライセンスの下でPythonパッケージとして無料でインストールおよび利用可能です。
Model Provider CostsVaries
推論、埋め込み、リトリーバル、ファインチューニングのコストは、設定されたモデルプロバイダー、API使用量、およびインフラストラクチャに依存します。
Self-Managed ProductionInfrastructure-dependent
ホスティング、モニタリング、評価データ、シークレット管理、キャッシュ、モデルエンドポイント、およびデプロイ運用はユーザー側の責任となります。
料金確認日: 2026年7月2日 · 利用上限、モデルの料金、サブスクリプションは別々に請求される場合があります。
機能と詳細
プログラミングモデル
- 入出力の振る舞いを宣言するための型定義されたシグネチャ
- Predict、ChainOfThought、ReActなどの構成可能なモジュール
- ハードコードされたプロンプトテンプレートに代わるPythonファーストなパイプライン
- 抽出、分類、RAG、エージェントのための再利用可能なプログラムコンポーネント
最適化と評価
- メトリクスと例題に基づいてプログラムをコンパイルするオプティマイザ
- マルチステージLMプログラムのためのプロンプトとデモンストレーションの最適化
- 独自のスコアリング関数と学習用例題のサポート
- 最適化されたプログラムの保存とリロード
モデルとプロバイダーの柔軟性
- プロバイダーのモデル文字列を使用して dspy.LM で構成
- 幅広いプロバイダーとの互換性を確保するため、バックエンドで LiteLLM を使用
- モジュールロジックを書き直すことなくプロバイダーの切り替えが可能
- APIベースまたは互換性のあるローカル/セルフホストのモデルエンドポイントで使用可能
エージェントとツール
- ReAct形式のツール利用モジュール
- 通常のPython関数をツールとして公開可能
- リトリーバル、検索、計算、マルチステップワークフローに有用
- 中間ステップを検査可能なモジュール型エージェントループをサポート
開発ワークフロー
- pip install dspy でインストール可能
- Python 3.10以降に対応したパッケージ
- MITライセンスのGitHubプロジェクト
- 通常のPythonプロジェクト、ノートブック、サービス、実験環境内で動作
なぜDSPyを選ぶのか?
DSPyは、プロンプトエンジニアリングがソフトウェアエンジニアリングへと進化し始める段階で真価を発揮します。単一のプロンプトであれば手動で管理できますが、本番環境のLLMシステムは、マルチステップの処理、リトリーバル(検索)の呼び出し、分類器、抽出タスク、ランキングロジック、ツール呼び出し、そして評価要件など、多くの要素で構成されます。
DSPyは、言語モデルの振る舞いを「プログラム」として扱うことで、この問題に対処します。開発者は長いプロンプト文字列を手書きする代わりに、構造化された入出力を定義し、モジュールを組み合わせ、メトリクス(指標)を設定します。すると、オプティマイザ(最適化器)が具体的な例題に基づいてプログラムを自動的に改善します。
DSPyの主な利点は、初心者にとってLLMアプリ開発が簡単になることではなく、本格的なLLMシステムをより体系的なものにできる点にあります。単発のチャットボットデモではなく、信頼性、回帰テスト、モデルの切り替え、コスト削減、そして数値化可能な品質向上を重視するチームにとって、非常に価値のあるツールとなります。
基本的なワークフロー
実用的なDSPyのワークフローは、各言語モデルのステップが何をすべきかを定義することから始まります。通常は、入出力の型を規定する「シグネチャ」の作成から着手します。次に、直接予測(Direct Prediction)、思考の連鎖(Chain-of-Thought)、検索拡張生成(RAG)、またはReAct形式のツール利用などのモジュールを選択します。
次のステップは評価です。有用な振る舞いを測定するための例題とメトリクスを定義することで、DSPyの真の力が引き出されます。メトリクスには、完全一致、意味的類似性、回答の忠実性、抽出精度、分類のF1スコア、人間の好みの反映、あるいは独自のスコアリング関数などを使用できます。
プログラム、例題、メトリクスが揃うと、オプティマイザがプログラムのより優れたバージョンを「コンパイル」します。これにより、すべてのプロンプトを手動で書き直すことなく、指示内容やデモンストレーション(Few-shot例)、マルチステージの振る舞いを改善できます。
簡略化されたワークフローは以下の通りです:
- シグネチャを用いてタスクのコントラクト(契約)を定義する。
- 推論戦略に適したモジュールを選択または構築する。
- 必要に応じてリトリーバー、ツール、外部関数を追加する。
- 学習用の例題とスコアリングメトリクスを作成する。
- プログラムに対してオプティマイザを実行する。
- 最適化されたプログラムを保存する。
- モデル間で品質、レイテンシ、コストを比較する。
- 通常のPythonアプリケーション内にプログラムをデプロイする。
これはプロンプトを繋ぎ合わせる(プロンプトチェイニング)のとは異なる考え方です。DSPyは開発者に、「何を測定し、最適化し、交換し、再利用すべきか」を問い直すことを促します。
主な用途
DSPyは、品質を測定できるタスクで最も強力です。これには、RAGシステム、質問回答(QA)、分類、データ抽出、ルーティング、要約パイプライン、サポート窓口の自動振り分け、ツールを利用するエージェント、マルチホップ推論ワークフローなどが含まれます。
RAGにおいて、DSPyが有用なのは、情報の検索、回答の生成、引用の振る舞い、忠実性をプログラムの独立したパーツとして表現できるからです。直感に頼って単一のプロンプトを調整する代わりに、チームはパイプライン全体を例題とメトリクスに基づいて最適化できます。
抽出や分類においては、構造化されたシグネチャによって期待される出力が明示されるため、自然言語のみのプロンプト特有の脆弱性が軽減されます。また、異なるモデルや推論戦略の比較も容易になります。
エージェント開発では、利用できるツールが限定されており、明確な成功基準がある場合にDSPyが最も役立ちます。目的が曖昧で評価セットが存在しない、自由度の高すぎる自律型システムにはあまり向いていません。
他のツールとの比較
LangChainが最も一般的な比較対象です。LangChainは、エージェント、チェーン、ツール、インテグレーション、アプリのオーケストレーションのための幅広い構成要素を提供します。対してDSPyは、言語モデルの振る舞いをプログラミングし、メトリクスに基づいて最適化することに特化しており、より一貫した手法を提示します。統合の幅広さやオーケストレーションのパターンを重視する場合はLangChainを、プロンプトやパイプラインの最適化が課題の中心である場合はDSPyを選択してください。
LlamaIndexは、RAG中心のアプリケーションにおいて強力な比較対象となります。LlamaIndexはデータの取り込み、インデックス作成、検索、ナレッジワークフローに深く焦点を当てています。DSPyは、検索結果を活用した推論や生成プログラムを最適化したい場合に適しています。多くのチームでは、データと検索インフラにはLlamaIndexを使い、構造化された言語モデルプログラムと最適化にはDSPyを組み合わせるという手法がとられています。
Haystackも検索やQAシステムにおいて実用的な選択肢です。本番環境の検索パイプラインや企業向け情報検索ワークフローには、Haystackの方が適していることが多いでしょう。言語モデルの呼び出しやマルチステップのプロンプト挙動の最適化が最大の課題である場合には、DSPyがより魅力的です。
Semantic Kernelは、Microsoftエコシステムを重視するチームや、プランナー/ツールベースのAIアプリを構築するチームに関連します。DSPyはエンタープライズ向けのフレームワークという側面は薄いですが、研究に裏打ちされたLLMプログラムの最適化レイヤーとして強力です。
InstructorやGuidanceは、構造化出力や生成制御という点でより近い比較対象です。スキーマ制約のある出力を得るだけであれば、これらの方が導入は簡単です。DSPyはより重厚ですが、マルチステージのプログラムを構成し、最適化するためのより広範なフレームワークをチームに提供します。
最適な構成
DSPyを最大限に活用するには、評価データを第一級の資産として扱う必要があります。最適化を始める前に、代表的な例題、失敗ケース、そして実際の製品目標を反映したメトリクスを定義すべきです。
RAGシステムであれば、質問、期待される回答、関連ドキュメント、忠実性のチェック項目を収集することを意味します。抽出タスクであれば、ラベル付きの例題とスキーマレベルのバリデーションが必要です。分類タスクでは、クラス定義、エッジケース、クラスの不均衡への配慮が求められます。
強力な本番環境のセットアップには、通常以下が含まれます:
- 高速なイテレーションのための小さな開発セット
- オプティマイザの判断のための独立した検証セット
- 回帰チェックのためのホールドアウト(取り置き)テストセット
- コストを抑えるためのモデル呼び出しのキャッシュ
- バージョン管理された最適化済みプログラム
- プロバイダーごとのレイテンシとコストの追跡
- モデルやオプティマイザの変更をリリースするための明示的なルール
また、DSPyは通常のソフトウェア開発の慣行と組み合わせるべきです。プログラムはソース管理下に置き、可能な限りCI(継続的インテグレーション)で評価を実行し、最適化された成果物はアプリケーションコードと同様にバージョン管理されるべきです。
導入・移行時の注意点
手書きのプロンプトからDSPyへの移行は、段階的に行うべきです。最初のターゲットとして最適なのは、入力と出力が明確で、評価データが存在する、管理の難しいプロンプトです。エージェントやRAGシステム全体を一度に書き直すと、DSPyによって改善されたのか、単に変数が多すぎて変化しただけなのかを判断するのが難しくなります。
現実的な移行パスは以下の通りです:
- 出力を測定可能な、プロンプトへの依存度が高いステップを1つ選ぶ。
- それをDSPyのシグネチャとモジュールに変換する。
- 利用可能であれば、20〜100個程度の代表的な例題を追加する。
- 実際の失敗パターンを捉えるメトリクスを定義する。
- 手書きのプロンプトとDSPyプログラムの結果を比較する。
- ベースラインが機能することを確認してから最適化を行う。
- 最適化されたプログラムを保存し、時間の経過とともに変化を追跡する。
LangChainやLlamaIndexから移行するチームは、すべてを置き換える必要はありません。DSPyは多くの場合、それらのシステム内部で「最適化された言語モデルレイヤー」として共存できます。例えば、検索部分はLlamaIndexに残し、回答生成、リランキング、あるいは事実確認のステップをDSPyモジュールとして実装することが可能です。
導入検討時のチェックリスト
DSPyを採用する前に、チームは以下の点を確認してください:
- プロジェクトに、単発のプロンプトではなく、繰り返し実行される言語モデルタスクがあるか?
- 有用な入出力のコントラクト(シグネチャ)を定義できるか?
- 評価セットとして活用できる例題やログがあるか?
- 主観的な好みを超えた、品質を反映するメトリクスがあるか?
- モデルの切り替え、コスト削減、プロンプトの最適化が真の価値を生むか?
- エンジニアリングチームがPythonコードとデプロイインフラを保守できるか?
- プロンプト、出力、トレース、キャッシュデータを安全に保存・検査できるか?
- パイプラインのどの部分が最適化され、どの部分が固定されているかを理解しているか?
これらの条件が揃っている場合、DSPyはLLM開発をより体系的なものにしてくれます。もしチームが単に素早いチャットボット構築を求めているのであれば、よりシンプルなフレームワークやホスト型のビルダーの方が適した出発点かもしれません。
対応モデルとデータプライバシー
対応モデル
- OpenAI
- Anthropic
- OpenRouter
- LiteLLM-compatible providers
プライバシーとデータの取り扱い
DSPyはローカルなPythonフレームワークであり、それ自体でホスト型のアプリケーション実行環境を提供するものではありません。データ露出の有無は、設定された言語モデルプロバイダー、リトリーバー、ベクトルデータベース、ロギング、キャッシュ、テレメトリ、ノートブック、およびデプロイ環境に依存します。機密データを扱う前に、APIキー、入出力ログ、オプティマイザの学習用例題、キャッシュされたトレース、検索ドキュメント、およびプロバイダーのデータ保持ポリシーを確認してください。
ガイド、レビュー、トラブル対処
公開済みのガイドはまだありません。上記の公式ドキュメントをご参照ください。
製品の更新情報
確認済みの製品更新はまだありません。フォローすると関連する新着情報を「保存済み」で確認できます。
関連コンテンツの更新履歴を見る代替ツール
LangChainLangChainは、LLMアプリケーションの構築、デバッグ、評価、デプロイのための開発者向けフレームワークおよびエージェントエンジニアリング・エコシステムです。 LlamaIndexLlamaIndexは、独自の構造化・非構造化データに基づいたコンテキスト対応LLMアプリケーションを構築するための開発者フレームワーク兼マネージド・ドキュメント・エージェント・プラットフォームです。
 HaystackHaystackは、本番環境のRAG、エージェント、マルチモーダル検索、コンテキストエンジニアリングLLMアプリケーションを構築するチームのための、オープンソースAIオーケストレーションフレームワークおよびエンタープライズプラットフォームです。
 Semantic KernelSemantic Kernelは、LLM、プラグイン、メモリ、ベクトルストア、既存コードをエージェント的なワークフローに統合するためのMicrosoft製オープンソースAIオーケストレーションSDKです。
 GuidanceLLMに厳密な構文や文法を守らせつつ、生成やツール利用をプログラムで制御したい開発者向けの制約付き生成ライブラリです。
 InstructorLLMやエージェントのアプリ向けに、モデルの応答を検証済みのデータへ変換する構造化出力の仕組みです。完全なエージェントフレームワークではなく、この機能に特化しています。
出典と確認記録
確認日は当サイトが情報を確認した日です。製品のリリース日は上に別途表示しています。
掲載情報の修正履歴
DSPyを、AI IDEやCLIコーディングエージェント、プロンプトからアプリを作成するツールではなく、開発者ワークフロー向けのフレームワークとして分類しました。
構造化されたシグネチャ、モジュール、オプティマイザ、Python 3.10以降への対応、MITライセンス、LiteLLMベースの柔軟性など、現在の公式なポジショニングを確認しました。