
 LlamaIndexLlamaIndexは、独自の構造化・非構造化データに基づいたコンテキスト対応LLMアプリケーションを構築するための開発者フレームワーク兼マネージド・ドキュメント・エージェント・プラットフォームです。

Haystack
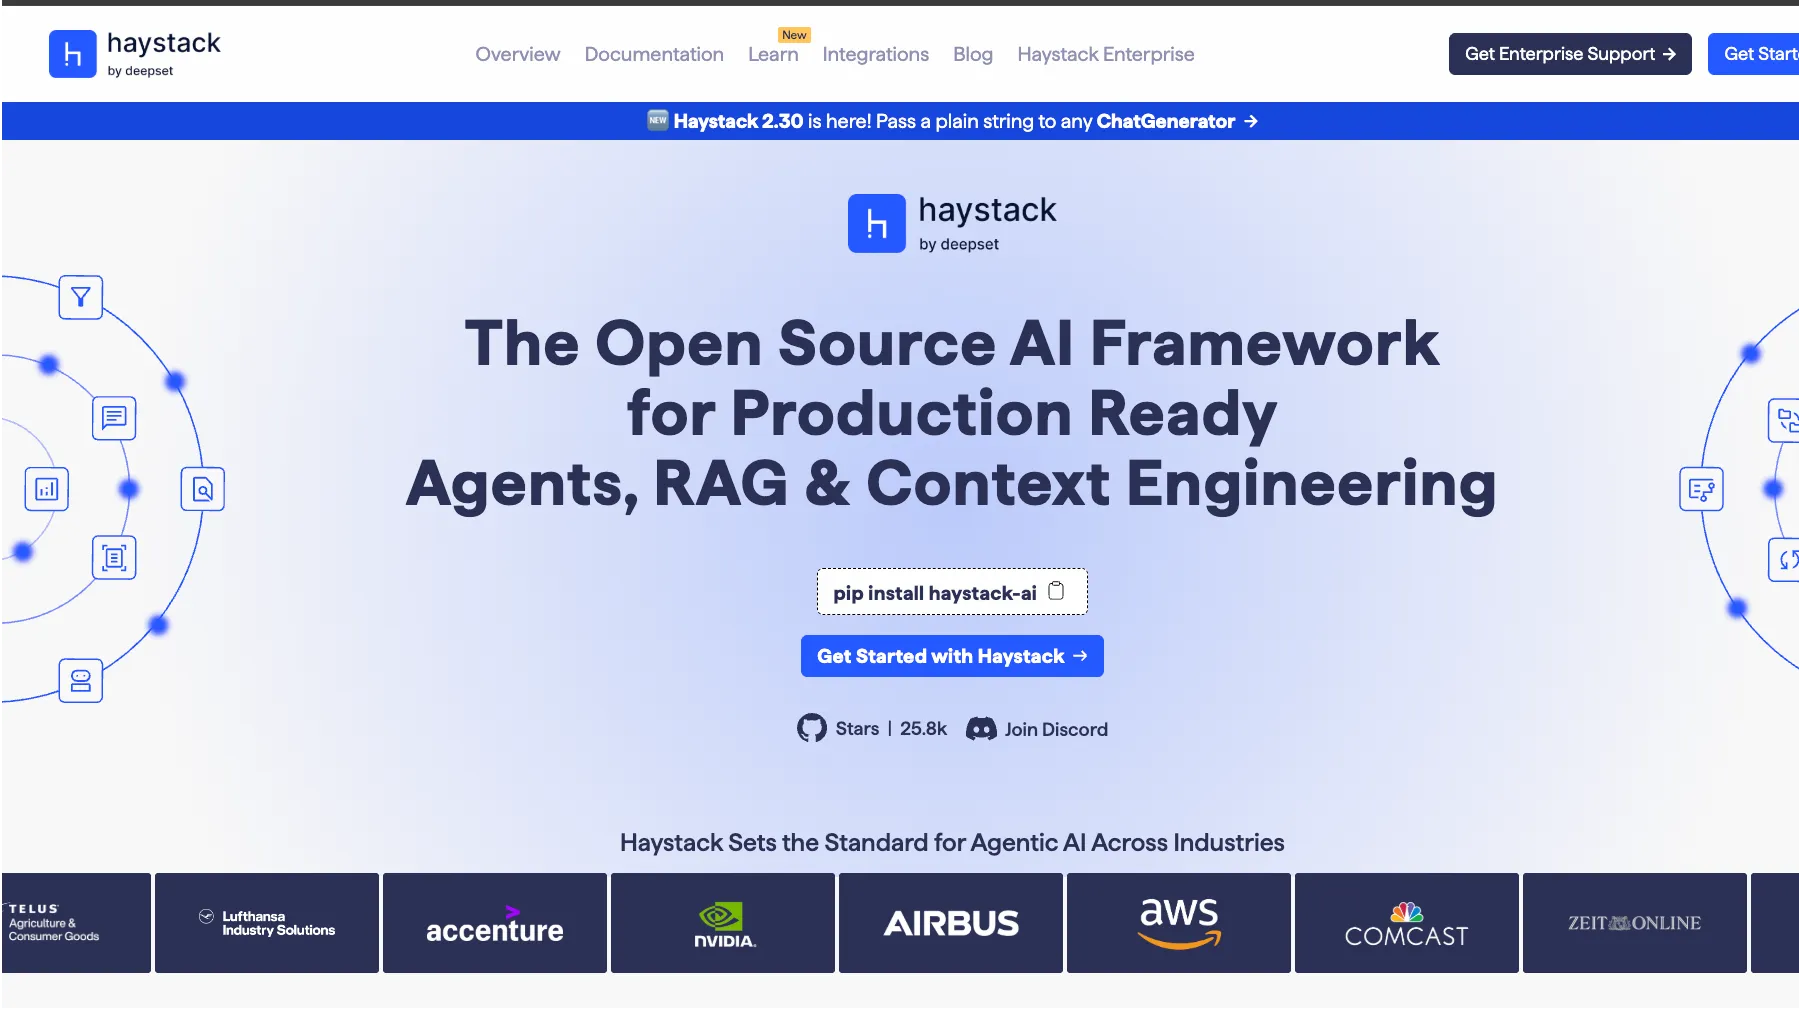
Haystackは、本番環境のRAG、エージェント、マルチモーダル検索、コンテキストエンジニアリングLLMアプリケーションを構築するチームのための、オープンソースAIオーケストレーションフレームワークおよびエンタープライズプラットフォームです。
情報確認日: 2026年7月8日 ·出典を見る
ツール情報
- 種類
- 開発ワークフロー
- 対応プラットフォーム
- Python, pip, Docker, Kubernetes, Web, Cloud, Self-hosted, On-premises, Local development
- 無料プラン
- 対応
- オープンソース
- 対応
- 独自の API キーを使用
- 対応
- ローカルモデル
- 対応
概要
適した用途
- 本番環境のRAGアプリケーション
- セマンティック検索システム
- コンテキストエンジニアリングを活用したAIエージェント
- マルチモーダル検索ワークフロー
- プライベートドキュメントに対する質問応答
- 検索、ルーティング、ランキング、生成を明示的に制御したいチーム
- オープンソースのポータビリティと、オプションの管理されたガバナンスを求める企業チーム
強み
- 本番環境のRAG、セマンティック検索、コンテキスト重視のAIシステムに最適です。
- Apache 2.0ライセンスのオープンソースであり、成熟したPythonエコシステムを持っています。
- モデルやベンダーに依存しないアーキテクチャにより、ロックインを軽減できます。
- 明示的なパイプライン設計により、検索、ルーティング、生成、評価の検査が容易です。
- エンタープライズプラットフォームにより、OSSに視覚的な構築、デプロイ、可観測性、ガバナンス機能を付加できます。
制約とトレードオフ
- CursorやWindsurfのようなAIネイティブなコードエディタを求める開発者
- ターミナル中心のコーディングエージェントを求めるチーム
- ノーコードのチャットボットビルダーを必要とする非エンジニアユーザー
- 検索やオーケストレーションを必要としない単純なプロンプトラッパー
- TypeScriptファーストのLLMフレームワークを必要とするフロントエンド中心のチーム
- AIコードエディタ、IDE拡張、または自律型コーディングエージェントではありません。
- Python中心のフレームワークです。TypeScriptを第一に考えるチームには他の選択肢が適している場合があります。
- 本番の品質は、依然として検索設計、評価、データガバナンス、インフラの選択に依存します。
- 商用エンタープライズ版の価格設定はカスタムであり、完全にセルフサービスではありません。
- 軽量なプロンプトラッパーライブラリに比べ、パイプラインモデルが構造化されすぎていると感じる場合があります。
使い始める
料金と利用上限
無料プランあり
Haystack Open SourceFree
Apache 2.0ライセンスのPythonフレームワーク。pipでインストール可能。ローカル、クラウド、またはセルフホストでのAIアプリ開発に利用できます。
Studio$0 / 月
個人プロトタイプ向けの無料プラン。1ワークスペース、1ユーザー、100パイプライン時間、50ファイル、2つの開発パイプラインが含まれます。
Haystack Enterprise StarterCustom / 契約ベース
Haystack OSSを利用するチーム向けのエンタープライズサポート。エンジニアへの相談、テンプレート、デプロイガイド、柔軟な価格設定を提供します。
EnterpriseCustom / 契約ベース
本番環境プラットフォームプラン。無制限のワークスペースとユーザー、カスタムリソース、高可用性パイプライン、クラウド/カスタムデプロイ、専用サポートを提供します。
料金確認日: 2026年7月8日 · 利用上限、モデルの料金、サブスクリプションは別々に請求される場合があります。
機能と詳細
パイプラインアーキテクチャ
- 構成可能なコンポーネントとパイプライン
- リトリーバー、ランカー、ルーター、ジェネレーター、コンバーター
- 分岐、ループ、条件付きルーティング
- デプロイとバージョン管理に適したシリアライズ可能なパイプライン
RAGと検索
- 密ベクトル、疎ベクトル、ハイブリッド検索パターン
- ドキュメントストアとベクトルデータベースの統合
- 質問応答(QA)とセマンティック検索
- 評価と実験のワークフロー
エージェントとツール
- ツール呼び出し(Tool-calling)エージェント
- メモリ機能とマルチステップワークフロー
- HayhooksとプラットフォームツールによるMCPサポート
- APIや社内システム用のカスタムコンポーネント
エンタープライズプラットフォーム
- YAMLおよびPython書き出し対応のビジュアルパイプラインビルダー
- プロンプトエクスプローラー、プレイグラウンド、プロトタイプ共有機能
- 実行履歴、トレース、ログ、回答の根拠(Groundedness)の可視化
- RBAC、SSO、監査ログ、ガードレール、クラウドまたはセルフホストデプロイ
Haystackが選ばれる理由
Haystackは、生のデータ、ツール、モデル呼び出しを信頼性の高いAIシステムへと変換するために、透明性の高いパイプラインが必要な場合に真価を発揮します。その中核となる思想は、本番環境のAIは「隠蔽されたエージェントのループ」ではなく、「明示的なコンポーネント」によって構築されるべきであるという点にあります。開発者は、情報の読み込み、変換、検索、ランキング、ルーティング、生成、評価、デプロイがどのように行われているかを正確に把握できます。
この点が、AIコーディングアシスタントとの大きな違いです。コーディングアシスタントがエディタ内での開発作業を支援するのに対し、HaystackはAIアプリケーション層そのものの構築を支援します。特に、検索の質、モデルの柔軟性、デプロイのポータビリティ、そしてオブザーバビリティ(可観測性)が重視されるプロジェクトに適しています。
Haystackを選ぶ最大のメリットは、アーキテクチャの制御性にあります。開発チームはシンプルなパイプラインから始めて、同じコンセプトモデルを維持したまま、ハイブリッド検索、カスタムコンポーネント、分岐ロジック、ループ、ツール呼び出し、評価、モニタリング、デプロイ自動化などを後から段階的に追加していくことができます。
主なワークフロー
一般的なHaystackプロジェクトは、パイプラインの境界を定義することから始まります。どのデータをシステムに取り込み、どのような変換を施し、どの検索戦略を採用し、どのモデルで回答を生成し、どこで検証や評価を行うかを決定します。
本番環境における最初のリスクは、通常LLMそのものではなく、「正しいコンテキストが、正しい形式でモデルに届いているか」という点にあります。Haystackのコンポーネントモデルは、変換、クリーニング、分割、埋め込み(Embedding)、検索、ランキング、プロンプト作成、生成、出力パースといった各ステップを、テスト可能なインフラとして扱うことを推奨しています。
プロジェクトが成熟するにつれ、パイプラインはより動的になります。キーワード検索を使うクエリもあれば、ベクトル検索やハイブリッド検索を使うものも出てくるでしょう。ユーザーのリクエストに応じてツール呼び出しが必要な場合もあれば、検索と生成だけで十分な場合もあります。Haystackは、これらのルートを明示的かつ検査可能、そして差し替え可能な状態で管理するのに適しています。
向いている用途
Haystackは、検索、情報抽出、コンテキストの質がユーザー体験の核心となる製品に最適です。例えば、企業のナレッジアシスタント、テクニカルサポート用のコパイロット、ドキュメントQA、法務・コンプライアンス検索、リサーチアシスタント、社内セマンティック検索、マルチモーダル検索、そして制御されたツールやデータへのアクセスを必要とするAIエージェントなどが挙げられます。
また、利用するプロバイダーの変更が予想される場合にも強力な選択肢となります。プロトタイプは特定のホスト型モデルとベクトルデータベースで開始しても、本番環境の要件によって、別のモデル、異なるドキュメントストア、プライベート環境でのデプロイ、あるいはローカル推論への変更が必要になることがあります。Haystackの価値は、これらの選択肢をアプリケーション設計にハードコードせず、交換可能なものとして扱える点にあります。
一方で、シンプルなチャットラッパー、フロントエンドのみのAIデモ、エディタのオートコンプリート機能のみを必要とするチームには、Haystackは多機能すぎるかもしれません。このフレームワークは、検索とオーケストレーションのレイヤーを自ら制御したい開発者を対象としています。
他の選択肢との比較
LlamaIndexと比較すると、Haystackはよりパイプライン中心の設計になっています。LlamaIndexは、高度なインデックス構築やドキュメントに特化したクエリレイヤーの作成に強みがありますが、Haystackは検索、ルーティング、生成、ツール、評価、デプロイまでを網羅する明示的なオーケストレーションを求めるチームに選ばれています。
LangChainと比較すると、Haystackはより構造化されており、肥大化を抑えた設計であると感じられるでしょう。LangChainは非常に広範なエコシステムを持ち、多種多様なLLMアプリに利用されますが、本番環境のRAG、セマンティック検索、コンテキストエンジニアリングにおいて、より明確なパイプラインモデルを求める場合にはHaystackが適しています。
LangGraphとの違いは、「グラフネイティブなエージェントの状態管理」か「パイプラインネイティブなAIオーケストレーション」かという点です。LangGraphは複雑な状態マシンや長時間実行されるエージェントフローに強い一方で、Haystackは検索、ランキング、モデル呼び出し、そして検査可能なデータフローを中心としたアプリケーションに強みがあります。
CrewAIやAutoGenと比較すると、Haystackは役割ベースのマルチエージェント連携よりも、エージェントに「正しいコンテキスト」を与えることに重点を置いています。正確な検索と制御されたツールアクセスが製品の鍵となる場合、Haystackの方が実用的な出発点となります。
推奨される構成
優れたHaystackのセットアップは、小さく始めることから始まります。まずは実際のユーザーの質問に答える最小限のパイプラインを構築し、測定可能な失敗が発生したときに初めて複雑さを追加してください。多くのRAGシステムが失敗するのは、パース、メタデータ、検索、ランキングの基本品質を検証する前に、エージェントやルーター、複数のモデルを導入してしまうためです。
プライベートデータを扱うアプリケーションでは、ドキュメントストア、埋め込みモデル、LLMプロバイダー、オブザーバビリティスタックを、一つのアーキテクチャ上の決定として同時に選択してください。これらのレイヤーは、プライバシー、レイテンシ、コスト、回答の質に相互に影響します。優れた構成であれば、アプリケーション全体を作り直すことなく、特定の部分だけを容易に交換できます。
エンタープライズ用途では、評価とトレースを後回しにせず、初期要件として扱ってください。実用上の問いは「デモで1つの質問に答えられるか」ではなく、「なぜその回答になったのか、どのコンテキストを使用したのか、どのコンポーネントが失敗したのか、バージョン間で何が変わったのかを説明できるか」であるべきです。
移行に関する注意点
独自のRAGスクリプトからHaystackへの移行は、現在のシステムを「取り込み」「検索」「生成」「評価」のステージに分離できればスムーズに進みます。まずは既存の挙動をシンプルなHaystackパイプラインとして再現し、その後で新しいコンポーネントを追加していくのが定石です。
LangChainからの移行では、境界線の定義に注目してください。一部のチームは検索とRAGパイプラインのみをHaystackに移行し、他のロジックは既存のまま残すという選択をしています。より明示的なパイプラインアーキテクチャを望む場合は、オーケストレーション層全体を置き換えることも可能です。
LlamaIndexからの移行は、単なる機能の有無ではなく、オーケストレーションのセマンティクス(意味論)を変えたいという動機が一般的です。既存システムがLlamaIndex特有のインデックスやクエリエンジンに強く依存している場合は、ワークフローごとに1つずつ移行し、回答精度、レイテンシ、根拠(Grounding)、運用上の複雑さを比較しながら進めることを推奨します。
導入時のトレードオフ
Haystackの主なトレードオフは、アーキテクチャを明示的に構築するため、設計上の決定事項が増える点です。コンポーネント、ドキュメントストア、リトリーバー、プロンプト構成、モデルプロバイダー、評価、デプロイについて検討する必要があります。この構造は本番環境では価値を持ちますが、素早いデモ作成には重く感じられる可能性があります。
また、Pythonファーストのエコシステムであることも考慮すべき点です。バックエンドのAIチームにとっては利点ですが、TypeScriptをメインに扱うチームの場合、HaystackをPythonサービスとして構築することは可能ですが、JavaScriptネイティブなフレームワークほど直感的ではないかもしれません。
Haystackを評価する最善の方法は、汎用的なチャットボットのテストではなく、実際の検索課題で試すことです。代表的なドキュメント、現実的なユーザーの質問、期待される出典の引用、そして失敗例を用意してください。透明性、プロバイダーの柔軟性、そして本番環境での制御性を重視するチームにとって、Haystackはワークフローに深くフィットするはずです。
対応モデルとデータプライバシー
対応モデル
- OpenAI
- Anthropic
- Mistral
- Cohere
- Hugging Face
- Azure OpenAI
- Amazon Bedrock
- Google Gemini
- Meta Llama
- NVIDIA
- Together AI
- Ollama
- Groq
- DeepSeek
- Qwen
- OpenRouter
プライバシーとデータの取り扱い
Haystack OSSは開発者自身の環境で動作しますが、プライバシーは設定されたLLMプロバイダー、埋め込みプロバイダー、ドキュメントストア、オブザーバビリティスタック、デプロイ先に依存します。Haystackはデフォルトで匿名のコンポーネント使用状況テレメトリを収集しますが、環境変数でオプトアウト可能です。エンタープライズプラットフォームではRBAC、SSO、監査ログ、ガードレールなどが追加されますが、本番導入前にはプロバイダーのルーティングや機密データの取り扱いについて確認が必要です。
ガイド、レビュー、トラブル対処
公開済みのガイドはまだありません。上記の公式ドキュメントをご参照ください。
製品の更新情報
確認済みの製品更新はまだありません。フォローすると関連する新着情報を「保存済み」で確認できます。
関連コンテンツの更新履歴を見る代替ツール
LlamaIndexLlamaIndexは、独自の構造化・非構造化データに基づいたコンテキスト対応LLMアプリケーションを構築するための開発者フレームワーク兼マネージド・ドキュメント・エージェント・プラットフォームです。 LangChainLangChainは、LLMアプリケーションの構築、デバッグ、評価、デプロイのための開発者向けフレームワークおよびエージェントエンジニアリング・エコシステムです。
 LangGraphLangGraphは、ステートフルで制御可能な長期実行AIエージェントおよびワークフローを構築する開発者のための、オープンソースで低レイヤーなエージェント・オーケストレーション・フレームワークです。
 Semantic KernelSemantic Kernelは、LLM、プラグイン、メモリ、ベクトルストア、既存コードをエージェント的なワークフローに統合するためのMicrosoft製オープンソースAIオーケストレーションSDKです。
 AutoGenAutoGenは、対話型エージェント、ツール利用、コード実行、エージェント間連携のためのMicrosoftのオープンソース・マルチエージェントAIフレームワークです。現在は主に既存プロジェクトの保守や移行計画に関連するツールとなっています。
 CrewAICrewAIは、役割ベースのエージェントチーム、イベント駆動型フロー、および実運用向けAI自動化を構築するチームのための、オープンソースのマルチエージェントフレームワーク兼プラットフォームです。
出典と確認記録
確認日は当サイトが情報を確認した日です。製品のリリース日は上に別途表示しています。
公式サイトHaystack ドキュメントHaystack GitHub リポジトリHaystack ライセンスdeepset 料金プランHaystack エンタープライズプラットフォームHaystack エンタープライズプラットフォーム ドキュメントHaystack エンタープライズスターターHaystack テレメトリ ドキュメント
掲載情報の修正履歴
公式サイト、ドキュメント、GitHubリポジトリ、ライセンス、料金、プラットフォーム資料に基づきディレクトリ項目を作成しました。