本页目录8 个章节
Key Takeaways
- Codex 的高频写盘问题并非谣言:实际检测显示,升级后
~/.codex/logs_2.sqlite仍然可能在活跃/流式响应期间大量写入 TRACE 日志。 - 风险不等于“SSD 立刻报废”:更准确的判断是,当前存在异常写盘风险,但是否严重取决于 WAL 是否持续膨胀、空闲时是否继续写入、磁盘写入速率是否异常。
- 升级仍然必要,但不能只看“已升级”:Codex 的 CLI、IDE 插件、Desktop、alpha/stable 版本可能节奏不同,升级到哪个构建比“有没有升级”更重要。
- 不要第一步就改数据库结构:SQLite trigger 可以作为紧急止血方案,但属于侵入式绕路处理。优先级应该是版本确认、只读检测、空闲采样、观察 WAL,再考虑备份和拦截 TRACE。
- AI 编程工具已经变成开发基础设施:Codex、Cursor、Claude Code、Windsurf 这类工具会长期运行、写日志、开本地服务、访问项目文件,必须像浏览器、Docker、Node 环境一样定期维护。
Codex 这个问题到底是什么?
最近围绕 OpenAI Codex 的一个讨论在开发者圈传播开来:
Codex 在流式任务和长时间运行时,可能会以较高频率写入
~/.codex/logs_2.sqlite,导致本地 SSD 写入量异常。
这个说法听起来很吓人,甚至有人把它称为“Codex 史诗级大 BUG”。
但从技术角度看,这件事不能简单归类为“AI 工具会写爆硬盘”。更准确的描述应该是:
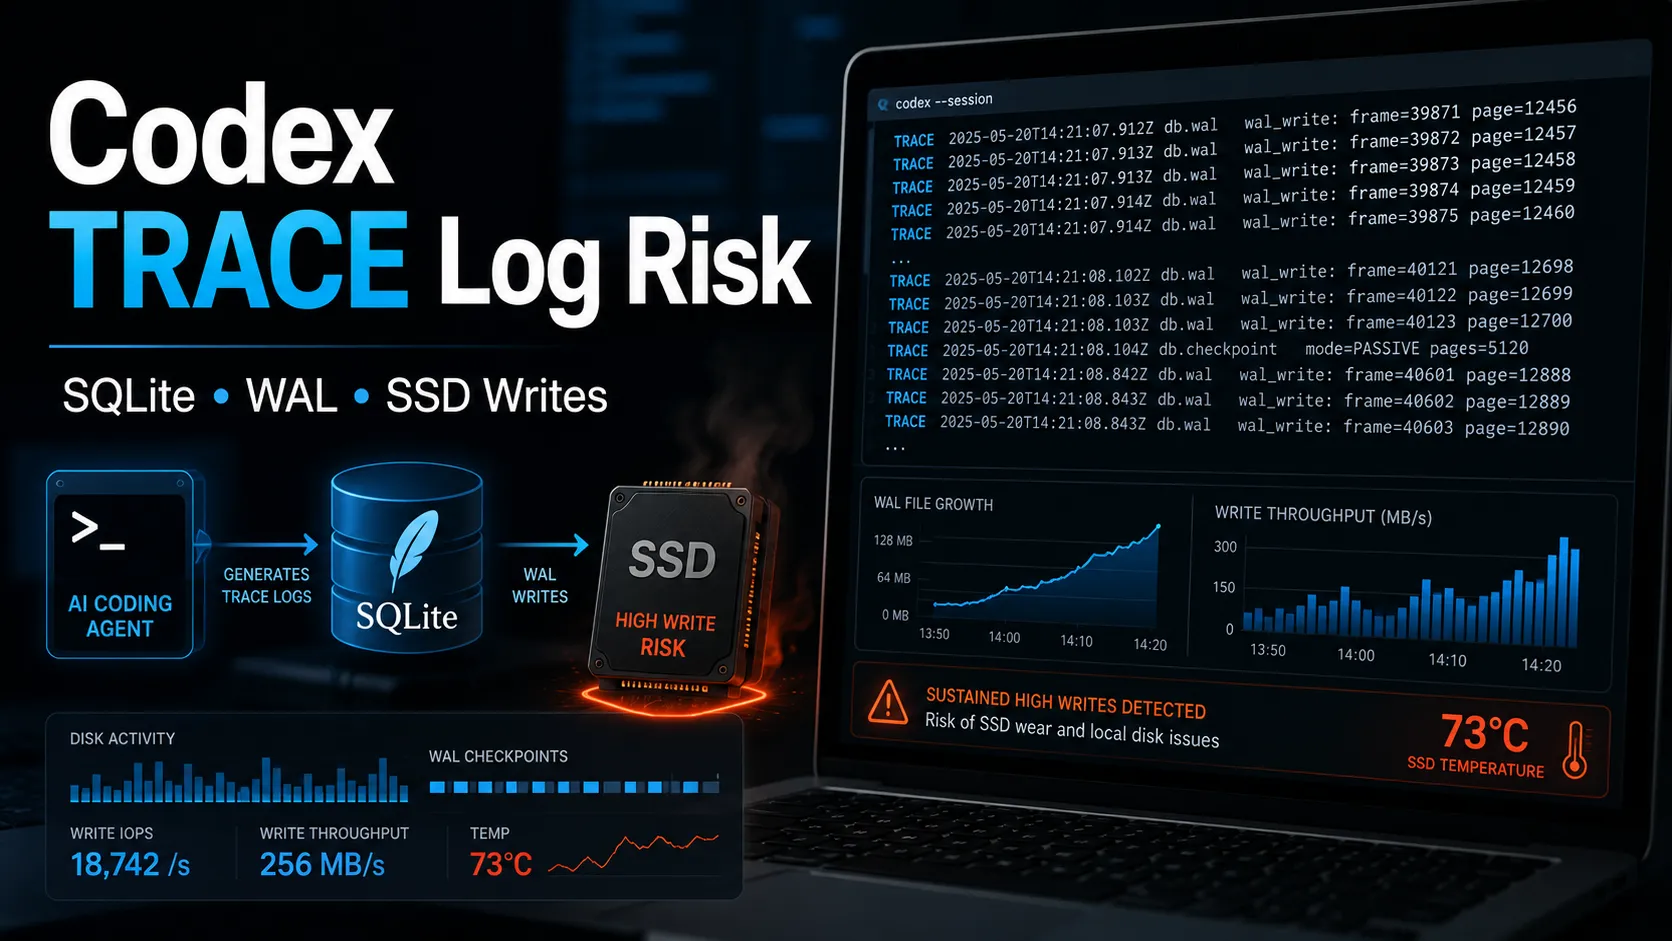
Codex 在部分版本和部分使用场景下,会把大量 TRACE 级别日志持久化写入本地 SQLite 数据库;在高强度、长时间、流式响应频繁的场景中,这可能造成不必要的磁盘写入压力。
这里的关键词有三个:
- TRACE 日志:通常是非常细的调试级日志,不应该在普通用户场景中大量持久化。
- SQLite/WAL:Codex 使用本地 SQLite 日志库,WAL 模式下会产生
logs_2.sqlite-wal文件。 - 流式响应:AI 编程助手在生成、调用工具、返回 token、同步消息时,可能触发大量事件日志。
问题不是模型本身“偷偷训练”,也不是 Codex 在下载巨量数据。
真正的问题是:本地日志系统可能过于吵闹。
实测结果:升级后仍然能看到高频 TRACE 写入
基于实际只读检测,升级后的 Codex 仍然出现了明显的 TRACE 日志写入。
检测过程没有执行备份、trigger、checkpoint、truncate,也没有修改 ~/.codex/logs_2.sqlite,只读取了文件体积、日志级别分布、表结构、MAX(id) 和 WAL 文件状态。
关键结果如下:
logs_2.sqlite:约 186 MB
logs_2.sqlite-wal:约 13.5 MB
当前保留日志:约 74,178 行
总体 TRACE:50,730 行,约 68.4%
最近 5000 条里 TRACE:3,932 条,约 78.6%
20 秒采样里 MAX(id):79,654,866 → 79,655,068,增加 202
最近一分钟 TRACE:1,885 条
WAL 大小:采样期间维持约 13.5 MB,未继续膨胀
最近日志 target 中仍然出现了多类流式链路相关模块:
codex_api::sse::responses
codex_api::endpoint::responses_websocket
codex_app_server::outgoing_message
codex_tui::markdown_stream
这些数据说明:
升级后,Codex 在活跃响应期间仍然存在较高频率的 TRACE 日志写入。
但同时也要注意另一个事实:
WAL 文件并没有在这次采样中持续膨胀。
这意味着当前更适合被判断为“异常写盘风险”,而不是“已经进入 SSD 灾难状态”。
为什么说“有问题”,但不是“马上写废 SSD”?
判断这类问题,不能只看一条指标。
MAX(id) 增长,说明日志插入仍在发生。
TRACE 占比高,说明日志级别确实偏吵。
但 WAL 没有持续变大,说明还没有观察到最危险的无界膨胀。
因此,实际结论应该分层:
已经可以确认的问题
- Codex 活跃/流式响应期间仍在大量写 TRACE。
- 最近 5000 条日志里 TRACE 占比接近 80%。
MAX(id)在 20 秒内继续增长。- 日志 target 与流式响应、WebSocket、SSE、TUI markdown stream 有关。
- 当前 shell 环境中未发现明显把日志级别设为 TRACE 的变量,例如
RUST_LOG、CODEX_LOG、OTEL_LOG_LEVEL。
暂时没有确认的问题
- 不能证明空闲状态下仍然持续狂写。
- 不能证明 WAL 正在无限膨胀。
- 不能证明当前机器的 SSD 已经受到严重损耗。
- 不能证明所有升级后的 Codex 版本都有相同表现。
所以最准确的判断是:
Codex 升级后仍然存在活跃任务期间 TRACE 日志高频写入问题;目前属于值得处理的本地 I/O 风险,但还不是“立即写废 SSD”的确定性结论。
为什么升级后还可能存在这个问题?
很多用户看到“官方修复已合并”后,会自然以为只要升级就完全没事。
但现实往往更复杂。
1. 你升级到的版本未必包含相关修复
Codex 可能存在多个分发渠道:
- CLI
- Desktop
- IDE 插件
- npm 安装版本
- Homebrew 安装版本
- GitHub release
- alpha / beta / stable 构建
不同渠道的更新时间可能不同。
所以“已经升级”并不等于“已经包含最新修复”。
更可靠的做法是确认实际运行版本:
codex --version
which codex
如果是在 VS Code、Cursor 或其他 IDE 中使用,还应该检查插件版本,以及插件内部调用的是哪个 Codex 二进制或服务。
2. 修复可能是“减少日志”,不是“彻底关闭日志”
从问题性质看,合理修复通常不会完全删除所有日志。
因为日志对排查问题仍然有价值。
更可能的修复方向是:
- 停止记录每个 WebSocket event。
- 过滤掉噪声过高的 target。
- 降低持久化日志级别。
- 减少 OpenTelemetry mirror events。
- 避免 SQLite insert-and-prune churn。
这类修复能显著减少写入,但不一定让 MAX(id) 完全停止增长。
因此,升级后仍然看到一些日志写入,并不奇怪。
真正要看的是:
- TRACE 占比是否下降。
- WAL 是否持续膨胀。
- 空闲状态是否还写。
- 活跃状态写入速率是否明显降低。
3. 流式 AI 工具天然更容易产生事件噪声
AI 编程助手和传统 CLI 工具不一样。
它不是执行一次命令就退出。
它可能持续处理:
- token stream
- SSE events
- WebSocket messages
- tool call lifecycle
- terminal output
- markdown 渲染流
- 文件变更
- agent 状态同步
- 插件事件
- 遥测/诊断事件
如果日志系统把这些事件全部记录下来,就很容易产生高频写入。
这也是为什么这类问题更容易出现在 Codex、Claude Code、Cursor、Windsurf 这类“agentic coding tool”上,而不是传统代码补全插件上。
如何判断自己的 Codex 是否中招?
建议先做只读检测,不要一上来就改数据库。
以下命令只读取文件和数据库,不会写入或清理:
DB="$HOME/.codex/logs_2.sqlite"
WAL="$DB-wal"

ls -lh "$DB" "$WAL" 2>/dev/null
sqlite3 -readonly "$DB" "SELECT level, COUNT(*) FROM logs GROUP BY level ORDER BY COUNT(*) DESC;"
sqlite3 -readonly "$DB" "SELECT MAX(id), COUNT(*) FROM logs;"
如果想观察是否还在增长,可以做多次采样:
DB="$HOME/.codex/logs_2.sqlite"
WAL="$DB-wal"

for i in 1 2 3; do
  date '+%F %T'
  sqlite3 -readonly "$DB" "SELECT MAX(id), COUNT(*) FROM logs;"
  ls -lh "$WAL" 2>/dev/null
  sleep 10
done
如果想看最近日志里 TRACE 占比:
DB="$HOME/.codex/logs_2.sqlite"

sqlite3 -readonly "$DB" "
SELECT level, COUNT(*)
FROM (
  SELECT level FROM logs ORDER BY id DESC LIMIT 5000
)
GROUP BY level
ORDER BY COUNT(*) DESC;
"
如果想看最近 target 来源:
DB="$HOME/.codex/logs_2.sqlite"

sqlite3 -readonly "$DB" "
SELECT level, target, COUNT(*)
FROM (
  SELECT level, target FROM logs ORDER BY id DESC LIMIT 5000
)
GROUP BY level, target
ORDER BY COUNT(*) DESC
LIMIT 20;
"
关键判断标准:看这 4 个指标
1. TRACE 占比
如果最近 5000 条日志里 TRACE 占比超过 50%,就值得关注。
如果超过 70%,说明日志级别明显偏吵。
实际检测中,最近 5000 条 TRACE 占比约 78.6%,这已经不是正常的用户级日志密度。
2. MAX(id) 增长速度
MAX(id) 代表日志插入序列。
如果 Codex 活跃时增长,可以理解。
如果 Codex 空闲几分钟后仍然快速增长,就更危险。
建议分别做两次测试:
- 活跃状态采样:Codex 正在回答或执行任务。
- 空闲状态采样:Codex 不生成、不跑命令、不执行工具,等待 2 到 3 分钟后采样。
如果空闲状态也持续增长,风险等级需要上调。
3. WAL 文件是否持续膨胀
logs_2.sqlite-wal 是观察风险的重要指标。
如果 WAL 长期维持在十几 MB,风险较低。
如果 WAL 快速涨到几百 MB、几 GB,甚至几十 GB,就需要立即处理。
实际检测中,WAL 约 13.5 MB,采样期间未继续变大。
这说明当前还没有进入最危险状态。
4. 系统层面是否出现异常 I/O
真正影响 SSD 和电脑体验的,不只是 SQLite 文件大小,而是系统实际写入量。
需要关注:
- 磁盘写入持续 MB/s 级。
- 风扇异常。
- IDE 卡顿。
- Codex Desktop 卡顿。
- macOS Activity Monitor 或 iostat 中磁盘写入异常。
- 系统长时间高 I/O wait。
如果这些现象和 Codex 活跃时间高度重合,问题就不仅是“日志文件看起来大”,而是实质性资源占用。
处理建议:从低风险到高风险
第一步:确认版本和安装来源
先确认当前真正运行的是哪个 Codex:
codex --version
which codex
如果存在多个安装源,例如 npm、Homebrew、IDE 插件同时安装,要特别小心。
常见坑包括:
- 终端里的 Codex 已升级,但 IDE 插件调用的是旧版本。
- npm 全局版本已升级,但 PATH 优先命中了 Homebrew 版本。
- Desktop 已升级,但 CLI 没升级。
- stable 版本没包含 alpha 中的最新修复。
第二步:做空闲状态采样
不要只在 Codex 正在回答时判断。
建议让 Codex 停止任务,空闲 2 到 3 分钟,再采样:
DB="$HOME/.codex/logs_2.sqlite"
WAL="$DB-wal"

for i in 1 2 3 4; do
  date '+%F %T'
  sqlite3 -readonly "$DB" "SELECT MAX(id), COUNT(*) FROM logs;"
  ls -lh "$DB" "$WAL" 2>/dev/null
  sleep 20
done
判断方式:
- 空闲状态
MAX(id)基本不涨:主要是活跃流式任务期间集中写入。 - 空闲状态
MAX(id)继续快速增长:更严重,说明后台也在持续写。 - WAL 同时持续膨胀:需要尽快止血。
第三步:检查环境变量
虽然实际检测中没有发现显式 TRACE 环境变量,但其他用户仍然应该检查:
env | grep -Ei 'RUST_LOG|CODEX_LOG|OTEL_LOG_LEVEL|LOG_LEVEL|TRACE'重点关注:
RUST_LOG
CODEX_LOG
OTEL_LOG_LEVEL
LOG_LEVEL
如果这些变量被设置为 trace,应优先取消或降级到 info / warn。
第四步:继续升级,但不要盲目追 alpha
建议策略是:
- 普通用户:优先使用最新稳定版。
- 重度用户:关注 release notes 和 GitHub issue,必要时测试预发布版。
- 团队环境:先在非关键机器验证,再统一升级。
- 出现磁盘异常:优先升级到包含日志修复的版本。
Codex 这类工具迭代非常快,升级不只是为了新功能,更是为了拿到本地 I/O、日志、权限、稳定性方面的修复。
第五步:短期降低使用风险
在确认问题完全修复前,高强度用户可以采取这些保守策略:
- 避免超长会话一直挂着。
- 大任务拆成多个小任务。
- 长时间使用后重启 Codex。
- 不需要时关闭 Codex 会话或后台进程。
- 避免多个 Codex 实例同时跑大任务。
- 定期检查
~/.codex目录大小。
这不是根治,但可以降低持续写入时间窗口。
是否应该用 SQLite trigger 拦截 logs 表?
社区流传的紧急处理方式大致是:
- 备份
logs_2.sqlite、logs_2.sqlite-wal、logs_2.sqlite-shm。 - 用 SQLite trigger 拦截
logs表插入。 - 执行
PRAGMA wal_checkpoint(TRUNCATE);。 - 采样确认
MAX(id)和 WAL 不再增长。
从技术上看,这个方案可以止血。
但它不是第一选择。
原因很简单:这属于修改 Codex 内部数据库结构。
可能带来的副作用包括:
- Codex 无法记录正常诊断日志。
- 后续升级迁移数据库时出现不兼容。
- 官方排查问题时缺少日志。
- trigger 规则写错后影响所有日志插入。
- 用户误以为“MAX(id) 不涨”就等于问题彻底解决。
如果一定要使用,建议优先考虑只拦截 TRACE,而不是拦截所有日志。
示例:
CREATE TRIGGER IF NOT EXISTS block_trace_logs
BEFORE INSERT ON logs
WHEN NEW.level = 'TRACE'
BEGIN
  SELECT RAISE(IGNORE);
END;
如果拦截所有日志:
CREATE TRIGGER IF NOT EXISTS block_all_logs
BEFORE INSERT ON logs
BEGIN
  SELECT RAISE(IGNORE);
END;
但 block_all_logs 更激进,会让 Codex 基本失去本地日志能力。
更合理的触发条件是:
- WAL 已经快速涨到几百 MB 或 GB 级。
- Codex 关闭后 WAL 仍无法收敛。
- 系统出现明显 I/O 卡顿。
- 空闲状态
MAX(id)仍持续增长。 - 升级后问题仍然严重。
在这些条件出现前,更建议先保持只读监控。
推荐的风险分级
低风险
特征:
logs_2.sqlite小于 200 MB。- WAL 小于几十 MB。
- Codex 空闲状态
MAX(id)不增长。 - 只有活跃响应期间增长。
- 系统没有明显卡顿。
建议:
- 继续升级。
- 每隔一段时间检查一次。
- 不需要改数据库。
中风险
特征:
- TRACE 占比超过 70%。
- 活跃状态
MAX(id)快速增长。 - WAL 暂时不爆,但长期使用后可能增长。
- 重度使用 Codex。
建议:
- 确认版本。
- 做空闲采样。
- 观察 WAL。
- 缩短长会话。
- 必要时备份后考虑拦截 TRACE。
实际检测数据更接近这个等级。
高风险
特征:
- WAL 持续涨到几百 MB、几 GB 或更高。
- 空闲状态也持续写入。
- 系统磁盘写入持续异常。
- Codex 或 IDE 明显卡顿。
- 日志文件反复膨胀。
建议:
- 退出所有 Codex 进程。
- 备份三个 SQLite 相关文件。
- checkpoint/truncate WAL。
- 升级或回退版本。
- 必要时临时拦截 TRACE。
- 向官方 issue 提供复现数据。
为什么这个问题值得开发者重视?
因为 Codex 这件事反映了一个更大的变化:
AI 编程工具正在从“插件”变成“本地开发基础设施”。
传统代码补全插件主要做建议。
而新一代 AI coding agent 会做更多事情:
- 读取项目上下文。
- 调用终端命令。
- 写文件。
- 管理会话状态。
- 连接远程模型。
- 启动本地 server。
- 接入 MCP。
- 记录 telemetry 和本地诊断日志。
- 持续处理流式事件。
这意味着它们的资源占用也会更接近一个长期运行的开发服务,而不是一个轻量插件。
过去开发者会定期升级浏览器,因为浏览器关系到安全和兼容性。
后来开发者会维护 Docker、Node、Python、数据库,因为它们关系到项目稳定性。
现在,Codex、Cursor、Claude Code、Windsurf 这类 AI 编程工具也进入了同一个维护范畴。
它们不应该“装完就忘”。
常见误区
误区一:文件只有 186 MB,所以没问题
不一定。
SQLite + WAL + insert/delete + checkpoint 可能造成实际写入量高于文件表面大小。
判断风险不能只看数据库文件大小,还要看:
MAX(id)增长速度。- WAL 是否持续膨胀。
- 系统层面实际写入。
- 空闲状态是否继续写。
误区二:升级了,所以一定修好了
不一定。
需要确认:
- 升级到了哪个版本。
- 当前实际运行的是哪个二进制。
- IDE 插件是否也升级。
- 修复是否进入当前渠道。
- 修复目标是减少日志还是彻底关闭日志。
误区三:加 trigger 后 MAX(id) 不涨,就彻底解决
不一定。
trigger 是拦截写入,不是修复 Codex 本身的日志策略。
它更像“堵住出口”,不是“解决源头”。
误区四:所有 TRACE 都必须拦截
不一定。
TRACE 的确不应该在普通场景大量持久化,但完全砍掉日志也会牺牲诊断能力。
更稳的方式是:
- 优先升级。
- 观察是否还有异常。
- 必要时只拦截高噪声 TRACE。
- 不要一开始就拦截所有 logs。
更推荐的长期做法
对个人开发者
- 每周或每两周检查一次 Codex 更新。
- 长时间使用后重启会话。
- 定期查看
~/.codex目录大小。 - 遇到系统卡顿时,把 AI 工具纳入排查范围。
- 不要长期停留在旧版本。
对团队
- 固定 AI coding tool 版本。
- 在团队机器上记录 Codex 版本和安装渠道。
- 将
~/.codex日志大小纳入异常排查 checklist。 - 在 CI、远程开发机、共享机器上限制长时间 agent 运行。
- 出现高 I/O 时先采样再处理,不要直接删库。
对工具开发者
Codex 这类问题也给所有 AI 工具开发者一个提醒:
- 用户机器不是调试环境。
- TRACE 不应默认大量持久化。
- 流式事件日志要采样或降级。
- WAL 文件需要健康管理。
- 日志保留策略要透明。
- 应提供关闭或降低日志级别的用户选项。
- 长时间 agent 运行必须考虑磁盘写放大。
结论
Codex 的 TRACE 日志高频写盘问题,不能被简单解读为“AI 工具会写废 SSD”。
更准确的结论是:
在实际检测中,升级后的 Codex 仍然可能在活跃/流式响应期间大量写入本地 SQLite TRACE 日志;这属于真实存在的本地 I/O 风险,但是否严重取决于 WAL 是否持续膨胀、空闲状态是否继续写入,以及系统层面是否出现异常磁盘写入。
当前最稳妥的处理方式不是恐慌卸载,也不是立刻改数据库结构。
更合理的路径是:
- 确认实际 Codex 版本。
- 做只读检测。
- 区分活跃写入和空闲写入。
- 观察 WAL 是否膨胀。
- 定期升级 Codex。
- 高风险情况下再备份、checkpoint、拦截 TRACE。
最重要的一点是:
AI 编程工具已经成为开发者的新基础设施,不能再按“普通插件”的方式长期放着不管。
如果正在高强度使用 Codex,建议立即做一次只读检测,并把 Codex 加入定期升级清单。
升级不是为了追新功能,而是为了拿到性能、日志、权限和稳定性修复。
继续阅读
更多围绕相同主题、协议或工具的文章。
引用的工具
浏览与本文主题相关的目录条目。