
 ModalModal 是一个无服务器计算平台,专为需要弹性云端执行且无需管理基础设施的 AI、数据、Python、GPU、批处理、沙箱、Notebook 和推理工作负载而设计。
RunPod
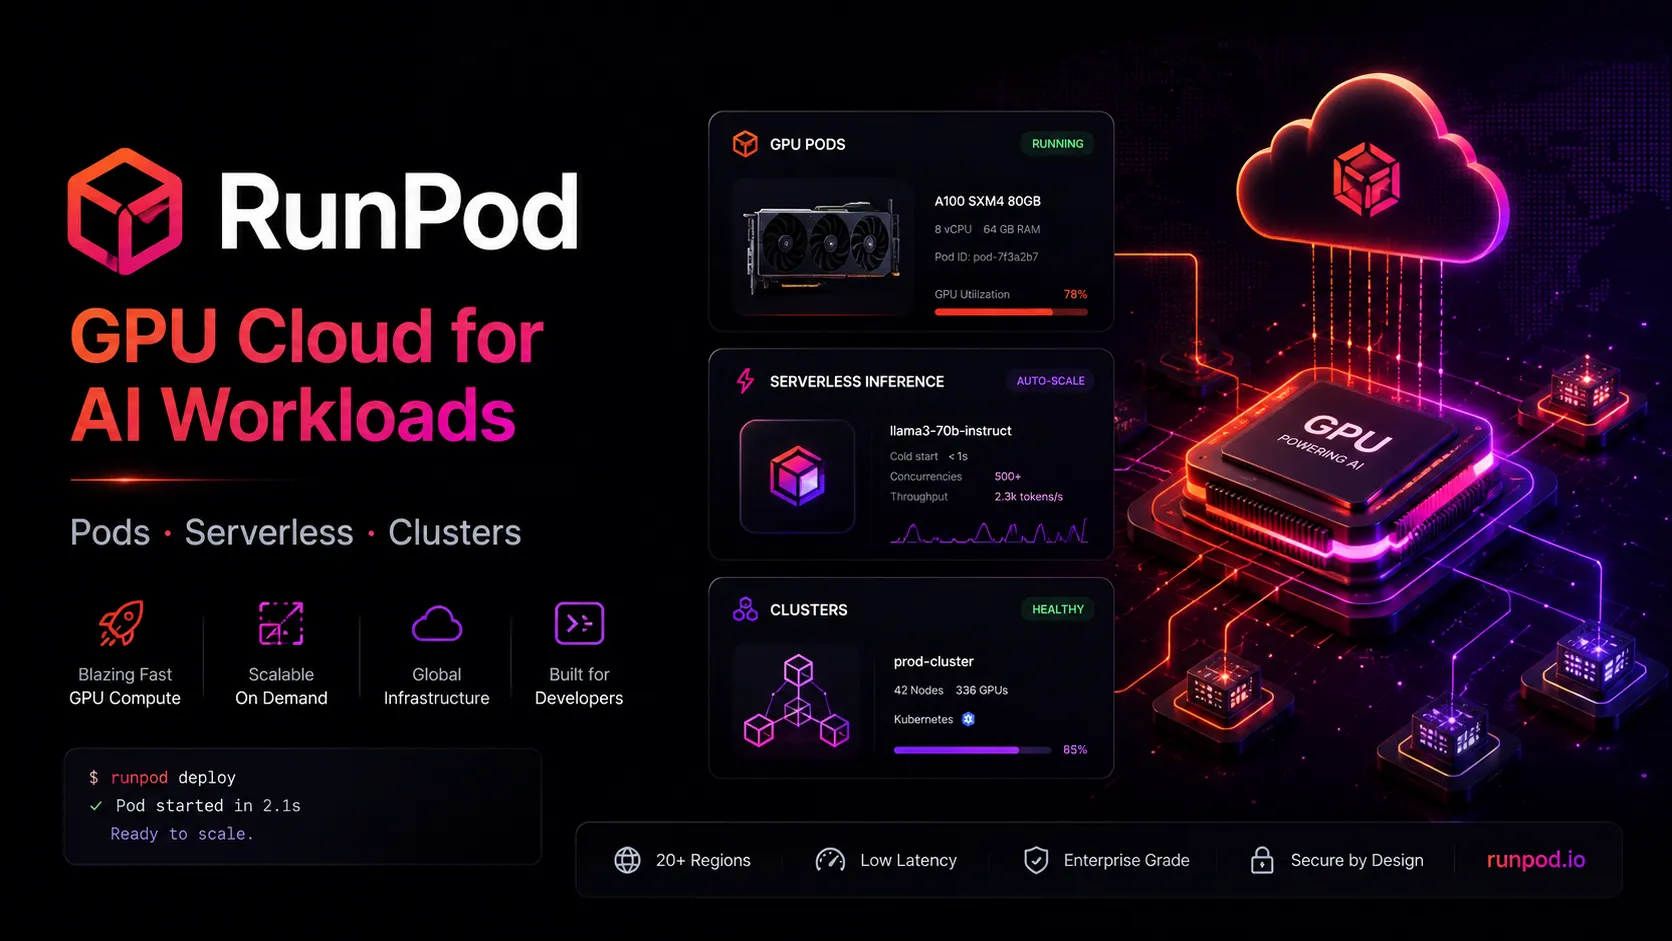
RunPod 是一个以 GPU 为核心的 AI 开发者云,提供交互式 GPU 实例、无服务器推理端点、公共模型 API 和多节点集群。
资料核对: 2026年6月16日 ·查看来源
工具信息
- 工具类型
- 开发工作流
- 平台
- Browser, API, Python SDK, Docker, JupyterLab, SSH, VS Code, Cursor, GitHub, Linux, CUDA, vLLM, ComfyUI, RunPod Serverless, RunPod Pods, RunPod Clusters
- 免费方案
- 不支持
- 开源
- 不支持
- 自带密钥
- 支持
- 本地模型
- 支持
工具概览
适合场景
- 需要按需使用 GPU 而无需购买硬件的 AI 开发者
- 部署 LLM、图像、音频或视频推理端点的团队
- 运行 ComfyUI、Stable Diffusion、vLLM、Ollama、笔记本或自定义 Docker 任务的开发者
- 在投入预留 GPU 容量前进行产品原型的初创公司
- 同时需要交互式开发 Pod 和生产级无服务器端点的团队
优点
- 广泛的 GPU 覆盖,适合 AI 训练、微调、推理、笔记本开发及音视频生成工作流。
- 同时支持交互式 GPU Pod 和自动扩缩容的无服务器 GPU 端点。
- 按秒计费和按需付费模式对波动性的 AI 任务具有极高的成本效益。
- 模板、JupyterLab、SSH、VS Code/Cursor 访问和 Docker 支持非常贴合开发者习惯。
- 公共端点和 Hub 模板减少了常用 AI 模型工作流的搭建时间。
局限与取舍
- 寻找 AI IDE、自动补全助手或代码审查机器人的开发者
- 不需要 GPU 计算的简单 Web 应用
- 需要全托管模型 API 且不愿进行容器或端点配置的团队
- 对长期运行的 GPU 任务缺乏成本控制能力的组织
- 需要 Windows Pod、UDP 支持或在 Pod 内运行 Docker Compose 的任务
- 本身不是 AI 代码编辑器或编程助手。
- GPU 可用性、价格和性能可能因区域、云类型和 GPU 级别而异。
- 无服务器推理需要精细配置冷启动、模型加载、队列和节点参数。
- 使用 Pod 需要用户自行管理容器、存储、端口、凭据以及养成关闭实例的习惯。
- 如果没有监控,存储、闲置资源和长期运行的 GPU 可能会产生意外费用。
开始使用
价格与使用额度
付费起价 $0.27
PodsFrom $0.27 / GPU/小时
用于开发和长期运行任务的专用 GPU 实例;起步价参考 RTX A5000 的公开定价。
ServerlessFrom $0.58 / GPU/小时
按需付费的无服务器 GPU 节点,用于推理端点;起步价参考 16GB 显存级别的公开定价。
ClustersFrom $1.79 / GPU/小时
用于分布式 AI 任务的多节点 GPU 集群;部分 GPU 型号需联系销售。
Reserved ClustersContact sales
具有可用性保证、自定义配置、SLA 在线率保障和企业折扣的专用 GPU 集群。
StorageFrom $0.05 / GB/月
持久化存储选项,包括容器磁盘、卷磁盘、网络存储和高性能存储。
Public EndpointsUsage-based
预部署的 AI 模型 API,涵盖图像、音频、语言和视频任务。
EnterpriseCustom
自定义容量、合规性支持、资源预留以及大规模 GPU 基础设施协议。
价格核对: 2026年6月16日 · 额度、模型费用与订阅价格可能分别计算。
功能与详细介绍
GPU Pods
- 按需使用的 GPU 和 CPU 实例
- 支持 SSH、JupyterLab、Web 代理以及 VS Code/Cursor 访问
- 提供常用 AI 环境的预设模板
- 支持自定义 Docker 容器
无服务器推理
- 无服务器 GPU 端点
- 按秒计费的节点计费模式
- 支持闲置自动关闭的自动扩缩容节点
- 处理函数和负载均衡端点
AI 任务支持
- 模型训练与微调
- LLM 推理与 vLLM 任务
- ComfyUI 与图像生成工作流
- AI 智能体与高算力任务
开发者工具
- Python SDK 与 API 支持
- Docker 镜像部署
- 支持从 GitHub 仓库部署无服务器节点
- 模板库、Hub 以及可复用的配置
存储与数据
- 容器磁盘存储
- 持久化卷磁盘
- 网络卷
- 兼容 S3 的存储 API
规模与运维
- 涵盖从小型推理卡到 H100、H200 和 B200 级别的 GPU 类型
- 提供安全云(Secure Cloud)和社区云(Community Cloud)选项
- 即时集群与预留集群
- 日志、指标、端点设置和节点调试工具
为什么选择 RunPod?
当 GPU 资源成为开发瓶颈时,RunPod 是极佳的选择。开发者无需购买本地硬件,也无需在早期就去洽谈昂贵的企业云容量,只需启动一个 GPU Pod 即可开始实验。随着业务增长,可以将推理任务迁移到无服务器端点,并在使用量趋于稳定后,通过集群或预留容量来扩展更重的工作负载。
该平台对 AI 开发者非常实用,因为它同时支持交互式开发和生产级工作流。研究人员或独立开发者可以打开 JupyterLab,或将 VS Code/Cursor 连接到 Pod;而产品团队则可以将模型部署在 API 端点后,仅在处理请求时付费。
核心工作流
典型的 RunPod 工作流通常从 Pod 开始。开发者选择 GPU 型号、存储类型、区域和模板,然后通过 SSH、JupyterLab、Web 代理或 VS Code/Cursor 进行连接。这是运行笔记本、模型实验、ComfyUI、微调和一次性计算任务最快的方式。
对于生产环境的推理,工作流会转向 Serverless(无服务器)。团队编写处理函数或 HTTP 服务,将其打包在 Docker 镜像中,部署到端点,并配置工作节点、扩缩容、缓存、冷启动行为和成本控制。这与长期运行的 Pod 逻辑不同:其目标是在保持可接受延迟的同时,将闲置成本降至最低。
对于大规模训练或分布式任务,集群和预留容量则更为适用。这些方案更适合已经了解自身资源利用模式、需要更稳定 GPU 可用性的团队。
适用场景
RunPod 适用于大语言模型(LLM)推理、图像生成、视频生成、语音处理、ComfyUI 工作流、Stable Diffusion 实验、微调、模型评估、批处理、AI 智能体、交互式笔记本以及自定义 CUDA 任务。
它也适合正在构建 AI 产品的开发者,作为原型到生产之间的桥梁。模型可以先在笔记本或 Pod 中进行实验,待 API 结构、延迟目标和成本模型明确后,再迁移到容器化的端点。
竞品对比
与 Modal 相比,RunPod 更侧重于 GPU 基础设施。Modal 在 Python 原生无服务器函数和开发体验方面表现出色,而 RunPod 则提供了对 GPU Pod、模板、容器、无服务器端点、公共端点和集群更直接的控制。
与 Replicate 相比,RunPod 提供了更多的基础设施控制权。Replicate 在打包和共享模型 API 方面更简单,而如果团队希望自主选择 GPU 类型、存储、容器、端点配置和开发环境细节,RunPod 是更好的选择。
与 Vast.ai 相比,RunPod 的产品化程度更高。Vast.ai 以低价的算力市场吸引用户,而 RunPod 在 Pod、Serverless、模板、API、端点和企业级容量方面提供了更清晰的平台层支持。
与 Northflank 相比,RunPod 更加专注。Northflank 是一个带有 GPU 支持的通用应用部署平台,而 RunPod 主要是为模型开发和推理设计的 AI GPU 云。
最佳配置建议
进行实验时,建议从 Pod 和预装了所需环境的模板开始。这能减少安装 CUDA、PyTorch、JupyterLab 或模型工具的时间。对于需要跨 Pod 持久化的数据或模型文件,请使用网络卷(Network Volumes),并及时关闭闲置 Pod 以避免不必要的支出。
对于推理任务,只有在明确了模型的内存占用、启动时间、平均请求时长和流量模式后,再选择 Serverless。对于大模型,冷启动可能会严重影响用户体验,因此在确定无服务器方案更便宜或更快之前,团队应测试缓存模型、FlashBoot、活跃工作节点和负载均衡端点。
对于团队协作,建议尽可能隔离开发和生产账号或成本中心。当笔记本、实验和生产端点共享同一个计费界面时,很容易发生 GPU 成本超支的错误。
迁移建议
从本地 GPU 迁移的团队,应首先在 RunPod 模板或自定义容器中镜像本地环境。首要目标是实现可复现性,而非立即投入生产。一旦模型在 Pod 上稳定运行,再评估该任务适合长期运行的 Pod、Serverless 还是集群。
从传统云服务商(如 AWS/GCP)迁移的团队,应对比完整的成本模型,而非仅仅是 GPU 每小时单价。存储、闲置时间、冷启动、节点设置、区域可用性、数据传输和运维复杂度,其重要性不亚于标称的 GPU 价格。
从托管模型 API 迁移的团队,需要承担更多的管理责任,但也获得了更多控制权。对于自定义模型,RunPod 可能更便宜且更灵活,但它需要进行容器化、端点配置、监控、安全审查和成本管理。
模型支持与数据隐私
支持的模型
- Llama
- DeepSeek
- Qwen
- FLUX
- Stable Diffusion
- Whisper
- WAN
- Kling
- Sora
- IBM Granite
- Seedream
- Minimax
隐私与数据处理
RunPod 提供安全云和社区云基础设施选项。其文档说明了在欧洲数据中心区域处理数据的 GDPR 覆盖范围,并提供安全合规指南。由于用户经常运行自定义容器、模型、数据集和卷,团队在处理敏感数据前应仔细审查 Pod 类型、数据中心位置、密钥处理、日志记录和端点暴露情况。
指南、评测与常见问题
相关指南正在整理中,可以先查看官方文档。
产品动态
暂时没有经过核对的产品动态。关注后,新的相关内容会出现在「我的收藏」。
查看相关内容动态替代工具
ModalModal 是一个无服务器计算平台,专为需要弹性云端执行且无需管理基础设施的 AI、数据、Python、GPU、批处理、沙箱、Notebook 和推理工作负载而设计。 ReplicateReplicate 是一个 API 优先的 AI 模型平台,面向希望在不运行 GPU 基础设施的情况下实现托管推理和模型部署的开发者。
 NorthflankNorthflank 是一个全栈开发者平台和 PaaS,用于在 Northflank 云或客户自有云基础设施上部署生产工作负载、AI 基础设施、数据库、任务和预览环境。
 Together AITogether AI 是一个开发者基础设施平台,面向需要托管开源模型推理、微调、评估和基于 GPU 部署的团队,而非完整的 AI 代码编辑器。
 Fal AIfal.ai 是一个面向开发者的生成式媒体基础设施平台,用于调用托管 AI 模型 API 或在 Serverless GPU 基础设施上部署自定义模型。
 Fly.io一个以开发者为中心的云平台,结合了容器部署、全球分布的虚拟机和可编程网络,提供比传统 PaaS 更多的基础设施控制权。
信息来源与核对记录
核对日期记录本站何时检查信息;不代表产品发版日期。
官方网站官方定价RunPod 文档概览Pods 文档Pods 定价文档Serverless 文档Serverless 定价文档Serverless 端点文档API 参考GPU 类型参考安全与合规文档RunPod 合规页面
本站资料修订记录
基于 RunPod 官网、定价页、文档概览、Pod、Serverless、端点、API、GPU 类型及安全合规资料创建初始条目。