
 Hugging Face Inference EndpointsHugging Face Inference Endpoints 是一个为需要专用生产推理 API 的开发者和机器学习团队提供的托管式 AI 模型服务平台。
Replicate
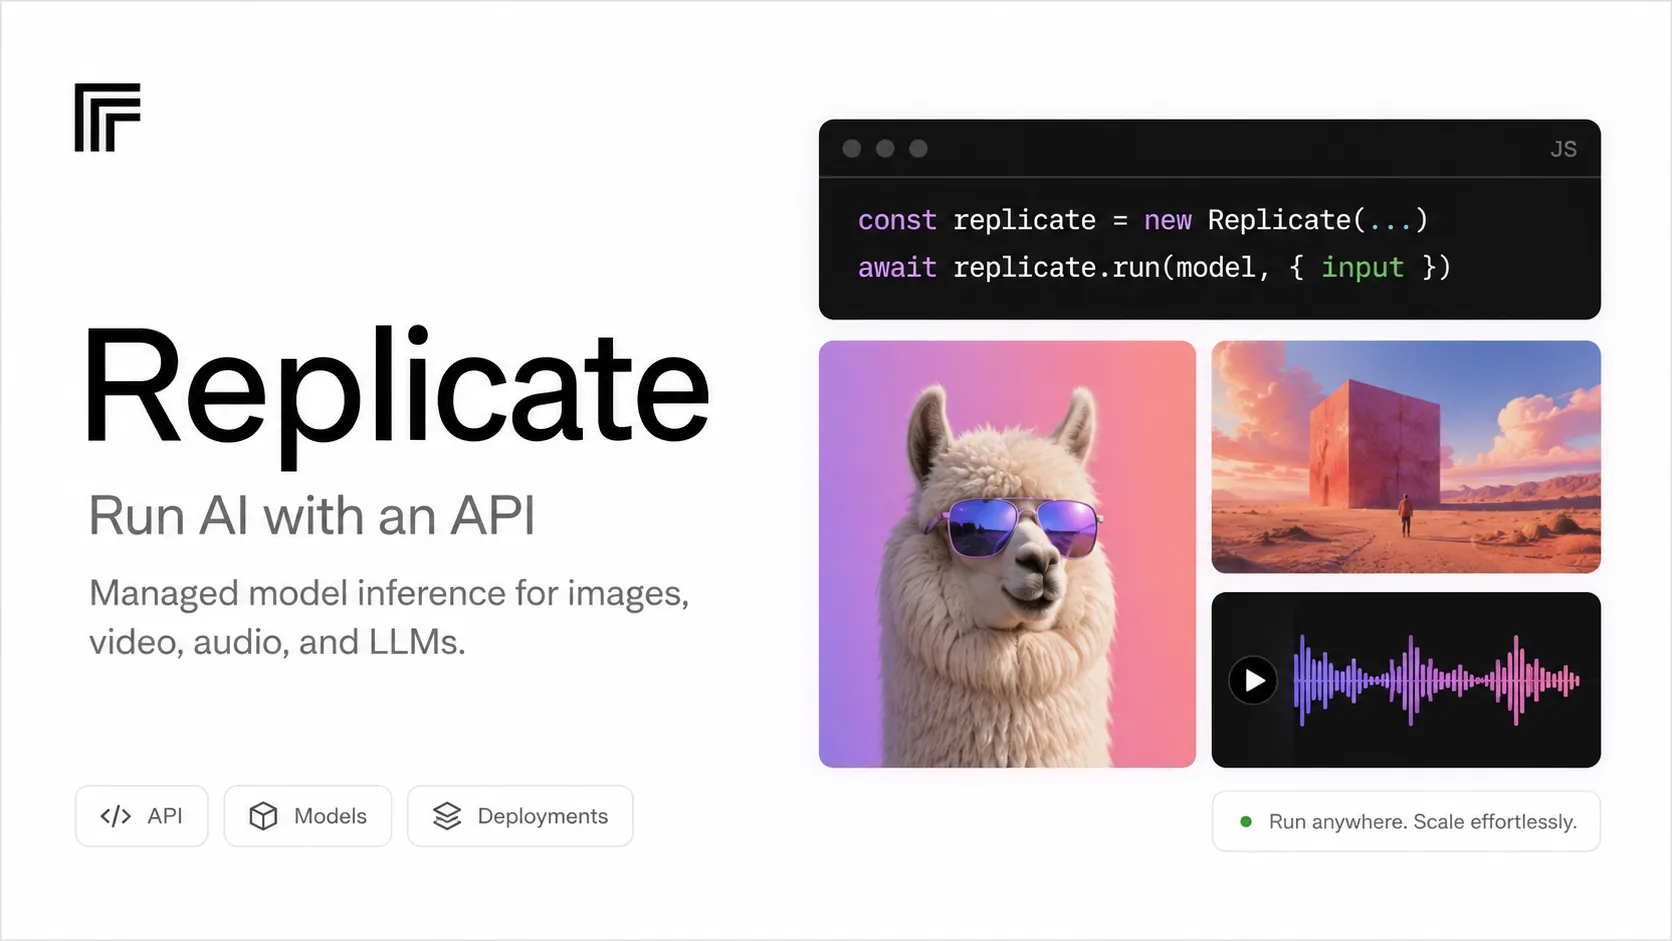
Replicate 是一个 API 优先的 AI 模型平台,面向希望在不运行 GPU 基础设施的情况下实现托管推理和模型部署的开发者。
资料核对: 2026年6月23日 ·查看来源
工具信息
- 工具类型
- 开发工作流
- 平台
- Web, HTTP API, Python, JavaScript/Node.js
- 免费方案
- 支持
- 开源
- 不支持
- 自带密钥
- 不支持
- 本地模型
- 不支持
工具概览
适合场景
- 为应用程序添加 AI 图像、视频、音频或 LLM 功能
- 在选择生产供应商之前测试多个模型
- 在不租用或配置 GPU 的情况下发布原型
- 通过 API 提供自定义模型服务
- 需要部署控制但无需完全掌握机器学习基础设施的团队
优点
- 从发现模型到实现 API 调用路径极短。
- 涵盖图像、视频、音频和语言工作流的广泛目录。
- 缩减至零(Scale-to-zero)特性适合波动较大的原型和产品流量。
- 自定义模型和部署功能使其不仅限于演示,更可用于生产。
- 非常适合不想管理 CUDA、队列和 GPU 的开发者。
局限与取舍
- 寻找 AI 代码编辑器的开发者
- 需要完全本地推理的团队
- 要求严格固定月度定价的工作负载
- 未经过企业隐私审查的高度受限数据流
- 无法容忍冷启动且未对部署进行优化的低延迟工作负载
- 并非 AI IDE、代码编辑器或编码助手。
- 按量计费的成本比固定订阅更难预测。
- 公共模型可能涉及共享队列、冷启动或扩缩容限制。
- 私有模型和部署可能会产生设置和空闲时长的费用。
- 敏感工作负载需要审查云端处理和数据保留策略。
开始使用
价格与使用额度
官方价格免费方案 · 付费起价 $0.0001
Limited free runs$0 / 受限
部分精选模型可在付费前免费试用。
Pay as you goFrom $0.000100/sec / 按量计费
许多模型按硬件时长计费;部分官方模型按 Token、图像数量或输出结果计费。
DeploymentsUsage-based / 实例时长
专用可扩展端点按设置、空闲和活跃实例时长计费。
EnterpriseCustom
提供批量折扣、预留算力、优先支持、SLA 和客户管理。
价格核对: 2026年6月23日 · 额度、模型费用与订阅价格可能分别计算。
功能与详细介绍
模型获取
- 通过统一 API 运行公共社区和官方模型
- 在集成前通过浏览器游乐场测试模型
- 使用版本化模型以获得可重复的输出
生产环境集成
- 提供 Python 和 JavaScript 客户端库的 HTTP API
- 支持同步、异步、流式传输和 Webhook 工作流
- 通过“部署”功能实现稳定端点和受控扩缩容
自定义模型运维
- 发布私有或公开模型
- 为模型和部署选择硬件配置
- 微调受支持的图像模型
团队与安全
- API 令牌管理
- 通过组织功能共享私有模型
- 企业合同、SLA 和更高的 GPU 配额
为什么选择 Replicate?
当难点不在于编写提示词代码,而在于将模型转化为可靠的产品功能时,Replicate 就派上用场了。开发者可以在浏览器中评估模型,然后通过 API 调用将相同的想法迁移到后端服务中。这对于构建 AI 图像工具、视频工作流、音频功能、内部自动化或模型对比页面的小型团队来说尤其切合实际。
与 AI IDE 的主要区别在于其运作层级。Replicate 并不尝试编辑你的代码仓库或成为你的开发环境。它作为托管推理基础设施存在于应用程序后端。对于已经拥有 Next.js、Python、移动端或后端技术栈的团队来说,这通常比采用全栈式 AI 应用构建工具更简洁。
核心工作流程
典型的工作流程从模型选择开始。首先在 Web 游乐场(Playground)中测试候选模型,对比输入模式(Schema)和输出质量,然后在接入应用程序之前锁定具体的模型版本。版本锁定至关重要,因为模型行为会随时间变化,而生产环境的产品需要可重复的输出。
对于原型开发,调用公共模型通常是最短路径。一旦延迟、流量或可靠性变得重要,建议将工作负载迁移到“部署(Deployment)”后端,以便更轻松地控制端点、硬件和扩缩容行为。对于耗时较长的任务,应优先选择异步预测和 Webhook,而不是阻塞用户请求直到模型完成。
适用场景
Replicate 适合构建面向最终用户的 AI 功能的产品团队:背景移除、图像生成、超分辨率、语音处理、文本转视频、头像生成、创意编辑或由模型驱动的内部工具。它也适用于目录、基准测试和对比网站,因为同一个产品可以调用多个模型系列,而无需每次都重建整个基础设施层。
如果工作负载纯粹是代码辅助,它的吸引力就没那么大。如果开发者寻求的是代码补全、编辑器内聊天、全库重构或自主创建 PR,则应对比 GitHub Copilot、Cursor、Windsurf、Claude Code 或 Devin 等工具。Replicate 属于应用运行时,而非编码界面。
竞品对比
与 Hugging Face Inference Endpoints 相比,Replicate 在快速尝试和调用各种生成式模型方面通常更具产品导向。对于已经深入 Hugging Face 生态系统的团队,尤其是当模型卡片、数据集、Spaces 和企业级机器学习治理是工作流核心时,Hugging Face 可能更自然。
与 Modal、RunPod 或更底层的 GPU 平台相比,Replicate 牺牲了一部分基础设施控制权以换取速度。如果团队希望掌握更多服务代码、依赖栈、批处理策略或 GPU 成本优化,这些平台可能更好。如果团队希望模型 API 像托管的产品原语一样简单,Replicate 则更具吸引力。
与 OpenAI 或 Anthropic 等单一供应商 API 相比,Replicate 的范围更广且支持多模态。代价是每个模型可能都有自己的 Schema、延迟特性、许可协议、质量水平和成本表现,因此团队需要更强的评估和路由管理能力。
最佳配置建议
对于生产环境的应用,切勿在客户端代码中暴露 Replicate API 令牌。应将调用放在后端路由、任务队列或 Serverless 函数之后,并仅存储实际需要的输出。由于媒体模型的处理时间可能长于普通 API 请求,请添加显式的超时、重试机制和用户可见的任务状态。
记录每次运行的模型名称、版本、请求参数、延迟和预估成本。这会使调试质量回退、对比模型升级以及识别高成本提示词变得容易得多。为开发、预发和生产环境使用独立的令牌,如果令牌被误提交到代码仓库,请立即更换。
对于用户生成的媒体内容,请独立规划存储。API 创建的预测数据并非永久资产存储,因此如果用户稍后需要查看或下载结果,请将输出复制到你自己的存储层。
迁移建议
如果你是从自托管推理迁移而来,在认定托管 API 是无缝替代方案之前,请先测试冷启动、吞吐量和输出一致性。运维负担通常会减轻,但成本透明度和单模型行为会变得更加重要。
如果你是从单一 AI 供应商迁移而来,请围绕模型调用创建一个薄薄的内部适配层。对输入、输出、错误处理和元数据进行标准化,使你的应用程序不会与特定的模型 Schema 强耦合。该适配层也便于日后在 Replicate 模型与其他替代方案之间进行 A/B 测试。
如果你打算迁出 Replicate,请先导出产品积累的各项参数:模型版本、提示词格式、文件处理方式、输出后处理逻辑以及重试行为。这些细节通常比 API 调用本身更重要。
模型支持与数据隐私
支持的模型
- FLUX
- Stable Diffusion
- Llama
- DeepSeek
- Claude
- Ideogram
- Recraft
- Veo
- Wan
隐私与数据处理
Replicate 是一项云服务,因此提示词、输入、输出、文件、日志和训练数据可能由 Replicate 处理。默认情况下,API 预测数据会在一小时后自动删除,而通过 Web 创建的预测数据将无限期保留除非手动删除;处理敏感工作负载时请查阅隐私政策、数据保留文档和企业条款。
指南、评测与常见问题
相关指南正在整理中,可以先查看官方文档。
产品动态
暂时没有经过核对的产品动态。关注后,新的相关内容会出现在「我的收藏」。
查看相关内容动态替代工具
Hugging Face Inference EndpointsHugging Face Inference Endpoints 是一个为需要专用生产推理 API 的开发者和机器学习团队提供的托管式 AI 模型服务平台。 ModalModal 是一个无服务器计算平台,专为需要弹性云端执行且无需管理基础设施的 AI、数据、Python、GPU、批处理、沙箱、Notebook 和推理工作负载而设计。
 RunPodRunPod 是一个以 GPU 为核心的 AI 开发者云,提供交互式 GPU 实例、无服务器推理端点、公共模型 API 和多节点集群。
 BasetenBaseten 是一个生产级 AI 推理平台,适用于需要将自定义或开源模型作为 API 进行部署、扩展和运营的团队。
 Together AITogether AI 是一个开发者基础设施平台,面向需要托管开源模型推理、微调、评估和基于 GPU 部署的团队,而非完整的 AI 代码编辑器。
 Fal AIfal.ai 是一个面向开发者的生成式媒体基础设施平台,用于调用托管 AI 模型 API 或在 Serverless GPU 基础设施上部署自定义模型。
 Amazon BedrockAmazon Bedrock 是一款 AWS 托管的生成式 AI 平台,面向构建安全模型驱动应用、Agent、RAG 系统及定制化基础模型工作流的企业和开发者。
 Vertex AIVertex AI(现已整合至 Google 的 Gemini Enterprise Agent Platform 品牌)是一个托管式 Google Cloud 平台,用于构建和运营 AI 应用,而非独立的 AI 代码编辑器。
信息来源与核对记录
核对日期记录本站何时检查信息;不代表产品发版日期。
本站资料修订记录
初始目录配置,基于 Replicate 官网、文档、定价、计费、数据保留、企业服务及隐私页面创建。