
 ReplicateReplicate 是一个 API 优先的 AI 模型平台,面向希望在不运行 GPU 基础设施的情况下实现托管推理和模型部署的开发者。
Fal AI
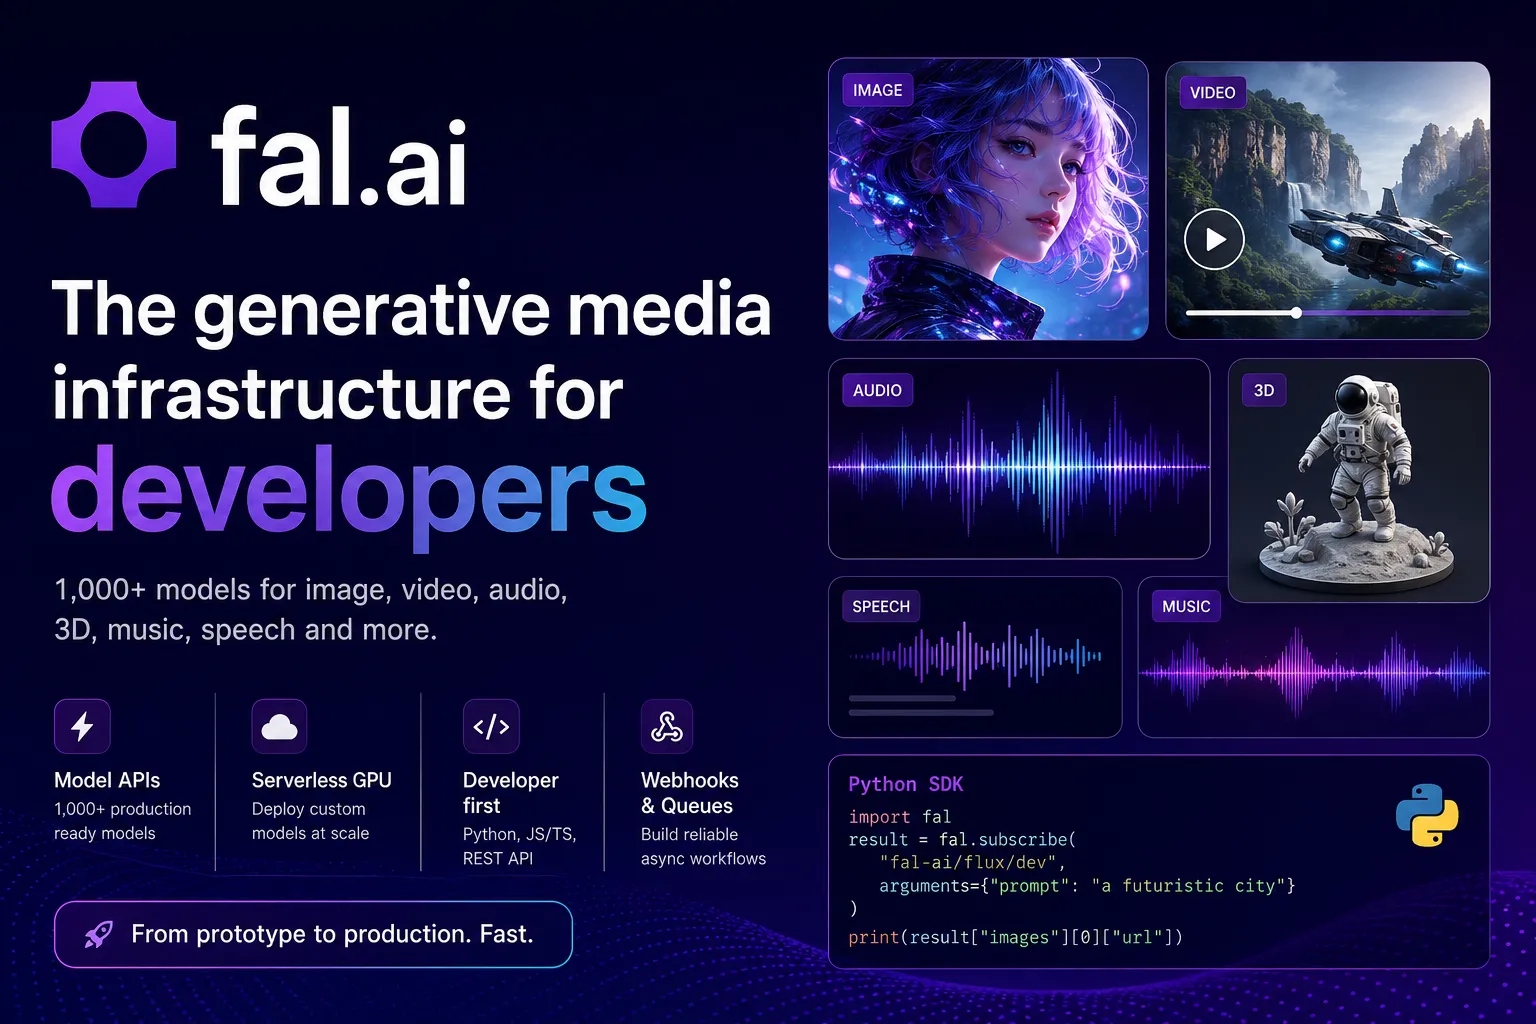
fal.ai 是一个面向开发者的生成式媒体基础设施平台,用于调用托管 AI 模型 API 或在 Serverless GPU 基础设施上部署自定义模型。
资料核对: 2026年6月16日 ·查看来源
工具信息
- 工具类型
- 开发工作流
- 平台
- Browser, API, Python, JavaScript, TypeScript, Node.js, React Native, REST, Docker, Serverless GPU, H100, H200, B200, B300, A100, ComfyUI
- 免费方案
- 支持
- 开源
- 不支持
- 自带密钥
- 不支持
- 本地模型
- 不支持
工具概览
适合场景
- 需要快速集成图像、视频、音频、3D 生成 API 的 AI 应用
- 为 Web、移动端或后端产品添加生成式媒体功能的开发者
- 在投入自定义基础设施前,需要对比测试多种托管 API 的团队
- 部署私有或微调媒体模型的 AI 初创公司
- 需要异步队列、Webhook 和可扩展推理流水线的产品
- 需要私有托管、专用基础设施和 SLA 支持的企业
优点
- 非常适合需要通过统一 API 调用图像、视频、音频、语音、音乐和 3D 模型的生成式媒体应用。
- 从 Playground 测试到生产级 API 集成路径极短,支持 Python、JS/TS 和 REST。
- Serverless GPU 模式允许团队部署自定义模型,无需直接管理 GPU 的自动扩缩容。
- 队列、流式传输和 Webhook 模式对于长耗时的视频生成和训练任务非常实用。
- 企业选项涵盖了私有托管、专用基础设施、SSO 和 SLA 保证等需求。
局限与取舍
- 寻找 AI 代码编辑器或 IDE 扩展的开发者
- 仅需要文本 LLM 对话或代码补全的团队
- 希望完全本地运行模型、不依赖云端的用户
- 需要简单静态托管或通用应用部署而非模型推理的项目
- 无法将 Prompt、媒体输入或输出发送给第三方云端基础设施的应用
- 本身并非 AI IDE、代码编辑器或编程助手。
- 模型定价随端点、输出尺寸、时长和生成设置的不同而有显著差异。
- 根据当前文档,自定义 Serverless 部署目前主要面向企业级用户。
- 长耗时媒体生成需要在应用层实现队列、Webhook、重试和成本预估逻辑。
- 团队在投入生产前必须审查特定模型的许可、安全、隐私及输出版权限制。
开始使用
价格与使用额度
提供免费方案
Free Tier$0
fal.ai 提供免费额度供入门使用;超出额度后的使用量按模型产出或计算资源消耗计费。
Model APIsUsage-based
预构建的模型端点按输出单位计费,例如按图像张数、百万像素、视频秒数或单个视频计费。
Image ModelsFrom $0.02 / 每百万像素
公开定价示例:Qwen 图像生成为 $0.02/百万像素,部分图像模型约为 $0.03-$0.04/张。
Video ModelsFrom $0.05 / 每秒
公开定价示例:Wan 2.5 为 $0.05/输出秒,可灵 2.5 Turbo Pro 为 $0.07/秒,Veo 3 为 $0.40/秒。
Serverless & ComputeFrom $1.89 / GPU/小时
自定义部署可在 GPU 基础设施上运行,H100 定价低至 $1.89/小时。
EnterpriseCustom
提供自定义模型、专用 Serverless 基础设施、SLA 保证、私有模型托管、SSO、用户管理及企业级支持。
价格核对: 2026年6月16日 · 额度、模型费用与订阅价格可能分别计算。
功能与详细介绍
模型 API
- 1,000 多个经过优化的模型端点
- 涵盖图像、视频、音频、音乐、语音、3D 及多模态模型
- 托管端点与自定义端点共用统一 API
- 模型页面提供 Playground、Schema、定价和代码示例
Serverless GPU
- 部署自定义 AI 模型和流水线
- 支持从零自动扩缩容至数千个 GPU
- 基于 Python 类的应用部署方式
- 按机器类型进行秒级运行计费
开发者 SDK
- Python 客户端
- JavaScript 和 TypeScript 客户端
- REST API 访问支持
- 提供快速集成的 cURL 示例
推理工作流
- 同步推理模式
- 基于队列的异步推理
- 流式更新支持
- 针对耗时任务的 Webhook 回调
自定义模型托管
- 私有模型端点
- 支持自带权重 (BYOW)
- LoRA 和微调模型工作流
- ComfyUI Serverless API 模式
企业级扩展
- 符合 SOC 2 标准
- 单点登录 (SSO)
- 私有部署端点
- 使用分析与优先技术支持
为什么选择 fal.ai?
当产品需要的是生成式媒体基础设施而非单一模型 API 时,fal.ai 是最佳选择。许多 AI 应用现在需要整合图像生成、视频生成、编辑、超分辨率、背景移除、语音、音乐、音效、3D、LoRA 工作流以及自定义流水线。fal.ai 将这些工作流封装在开发者 API 之下,并提供 Playground、Schema、定价参考、示例以及面向生产环境的推理模式。
其核心优势在于集成速度。开发者可以在浏览器中测试模型,复制 Python 或 JavaScript 代码,通过 API 密钥直接调用,并随着流量增长逐步转向队列、Webhook、私有端点或自定义 Serverless 部署。
核心工作流
最简单的工作流从 模型 API (Model APIs) 开始。从市场中选择模型,在 Playground 中测试,复制示例代码,然后通过 Python 客户端、JavaScript 客户端、REST API 或 cURL 从后端或应用中调用。这是大多数团队的理想切入点,因为它无需管理基础设施,且按模型产出计费。
对于视频生成、模型训练或复杂的媒体流水线等耗时任务,异步推理 (Asynchronous inference) 通常是更好的模式。应用提交请求,跟踪队列状态,接收进度或日志,并在完成后获取结果。Webhook 在此至关重要,因为它能避免在模型生成输出时保持用户端连接长时间开启。
对于专有模型或特殊流水线,fal Serverless 是进阶选择。团队编写 Python 应用,定义硬件需求,控制模型权重和运行时行为,由 fal 负责资源调度、扩缩容、网络和可观测性。
适用场景
fal.ai 适用于生成或转换媒体内容的产品:AI 图像编辑器、头像应用、视频生成工具、创意套件、广告生成平台、电商媒体工具、音乐和音效生成器、语音产品、3D 资产流水线以及 AI 设计工具。
它也非常适合智能体创意工作流 (Agentic creative workflows)。产品可以串联多个端点:生成图像、放大分辨率、移除背景、制作动画、合成音频并存储结果。当这些链式操作被视为包含成本预估、重试、队列和结果处理的生产级工作流时,该平台的优势最为明显。
竞品对比
与 Replicate 相比,fal.ai 在高性能生成式媒体推理和生产级模型 API 覆盖面上更具进取心。Replicate 在开源模型发布工作流上可能更简单,而 fal.ai 在追求速度、模型多样性、媒体流水线和 Serverless GPU 扩展性时更具吸引力。
与 RunPod 相比,fal.ai 在媒体 API 层做了更多抽象。RunPod 更适合需要直接控制 GPU Pod、Serverless Worker 和底层基础设施的团队。fal.ai 则适合想要开箱即用的模型,以及希望从托管 API 平滑过渡到私有自定义端点的团队。
与 Modal 相比,fal.ai 的通用性稍弱,但更专注于媒体模型。Modal 在 Python Serverless 计算和自定义基础设施逻辑方面表现出色,而 fal.ai 则针对生成式媒体端点、模型 Playground、按产出计费和 AI 媒体工作流进行了优化。
与 OpenAI 或 Google 的模型 API 相比,fal.ai 通过统一接口提供了更广泛的第三方和开源媒体模型。代价是团队必须独立评估每个模型的质量、价格、延迟、安全特性和许可协议。
最佳配置建议
对于新产品,在部署自定义基础设施之前,建议先从托管模型 API 开始。选择一两个候选模型,在 Playground 中测试质量和延迟,根据产出定价预估成本,并构建一个带有异步队列处理的小型集成。
对于生产级应用,应尽早实现成本预估。随着分辨率、时长、重试次数或批处理规模的增加,图像、视频和音频生成的成本会迅速上升。良好的集成应当显示预估成本、校验用户输入、强制执行输出限制,并优雅地处理失败或延迟的任务。
对于耗时任务,使用 Webhook 而非频繁轮询。将 Webhook 回调与幂等任务处理相结合,确保重复通知、重试或用户刷新不会导致重复计费或状态不一致。
对于企业级部署,应将敏感工作流隔离到私有端点中,并在接入专有内容或客户数据前,审查数据处理、模型访问控制、用户管理和 SSO 登录。
迁移建议
从单一模型供应商迁移的团队,应首先将当前的 Prompt、参数、输出格式和错误处理映射到 fal.ai 的端点 Schema。不要假设名称相似的模型行为完全一致,需对比输出质量、延迟、价格、随机种子行为、宽高比支持、安全过滤和后处理需求。
从自管 GPU 迁移的团队,应识别哪些工作负载是真正需要自定义的。通用媒体生成通过托管 API 可能会更便宜、更快速,而专有微调模型、自定义流水线或私有权重则更适合放在 Serverless 上运行。
从原型 Notebook 迁移的团队,应将生产工作流正式化:包括请求校验、异步任务状态、Webhook、存储、内容审核、重试限制、成本上限和模型降级方案。fal.ai 减轻了大部分 GPU 管理负担,但应用层仍需要完善的产品级控制。
模型支持与数据隐私
支持的模型
- GPT Image 2
- Seedance 2.0
- Flux 2
- Kling 3.0
- Veo 3.1
- Nano Banana Pro
- Ideogram 4
- Krea 2
- Wan 2.5
- Kling 2.5 Turbo Pro
- Veo 3
- Ovi
- Seedream V4
- Flux Kontext Pro
- Qwen
- MiniMax Speech-02 HD
- Dia TTS
- Beatoven Music
- Beatoven SFX
- ElevenLabs Music
隐私与数据处理
fal.ai 是云托管平台。条款规定客户保留输入内容的权利(需授予提供服务所需的许可),企业版资料显示客户数据不会用于训练 fal 模型。在发送专有或受监管数据前,请务必审查特定模型条款、API 服务条款、计算基础设施条款、隐私政策及数据保留政策。
指南、评测与常见问题
相关指南正在整理中,可以先查看官方文档。
产品动态
暂时没有经过核对的产品动态。关注后,新的相关内容会出现在「我的收藏」。
查看相关内容动态替代工具
ReplicateReplicate 是一个 API 优先的 AI 模型平台,面向希望在不运行 GPU 基础设施的情况下实现托管推理和模型部署的开发者。 RunPodRunPod 是一个以 GPU 为核心的 AI 开发者云,提供交互式 GPU 实例、无服务器推理端点、公共模型 API 和多节点集群。
 ModalModal 是一个无服务器计算平台,专为需要弹性云端执行且无需管理基础设施的 AI、数据、Python、GPU、批处理、沙箱、Notebook 和推理工作负载而设计。
 Together AITogether AI 是一个开发者基础设施平台,面向需要托管开源模型推理、微调、评估和基于 GPU 部署的团队,而非完整的 AI 代码编辑器。
 Hugging Face开放模型生态的主要平台,将模型和数据集发现、应用演示、智能体库、推理服务商与生产部署连接起来。
 Vertex AIVertex AI(现已整合至 Google 的 Gemini Enterprise Agent Platform 品牌)是一个托管式 Google Cloud 平台,用于构建和运营 AI 应用,而非独立的 AI 代码编辑器。
 Amazon BedrockAmazon Bedrock 是一款 AWS 托管的生成式 AI 平台,面向构建安全模型驱动应用、Agent、RAG 系统及定制化基础模型工作流的企业和开发者。
信息来源与核对记录
核对日期记录本站何时检查信息;不代表产品发版日期。
官方网站官方定价文档概览快速入门文档模型 API 概览推理方法文档异步推理文档Webhook 文档Serverless 介绍Serverless 定价文档平台定价 API企业版页面fal Python GitHub 仓库fal JavaScript GitHub 仓库服务条款隐私政策
本站资料修订记录
基于 fal.ai 官网、定价页、开发者文档、SDK 仓库及法律条款创建初始目录条目。