 Momentic这是一个对代码仓库友好的智能体 QA 平台,能将自然语言意图转化为具有自愈能力的 Web 和移动端测试,并填补 PR 和提交周边的覆盖率空白。
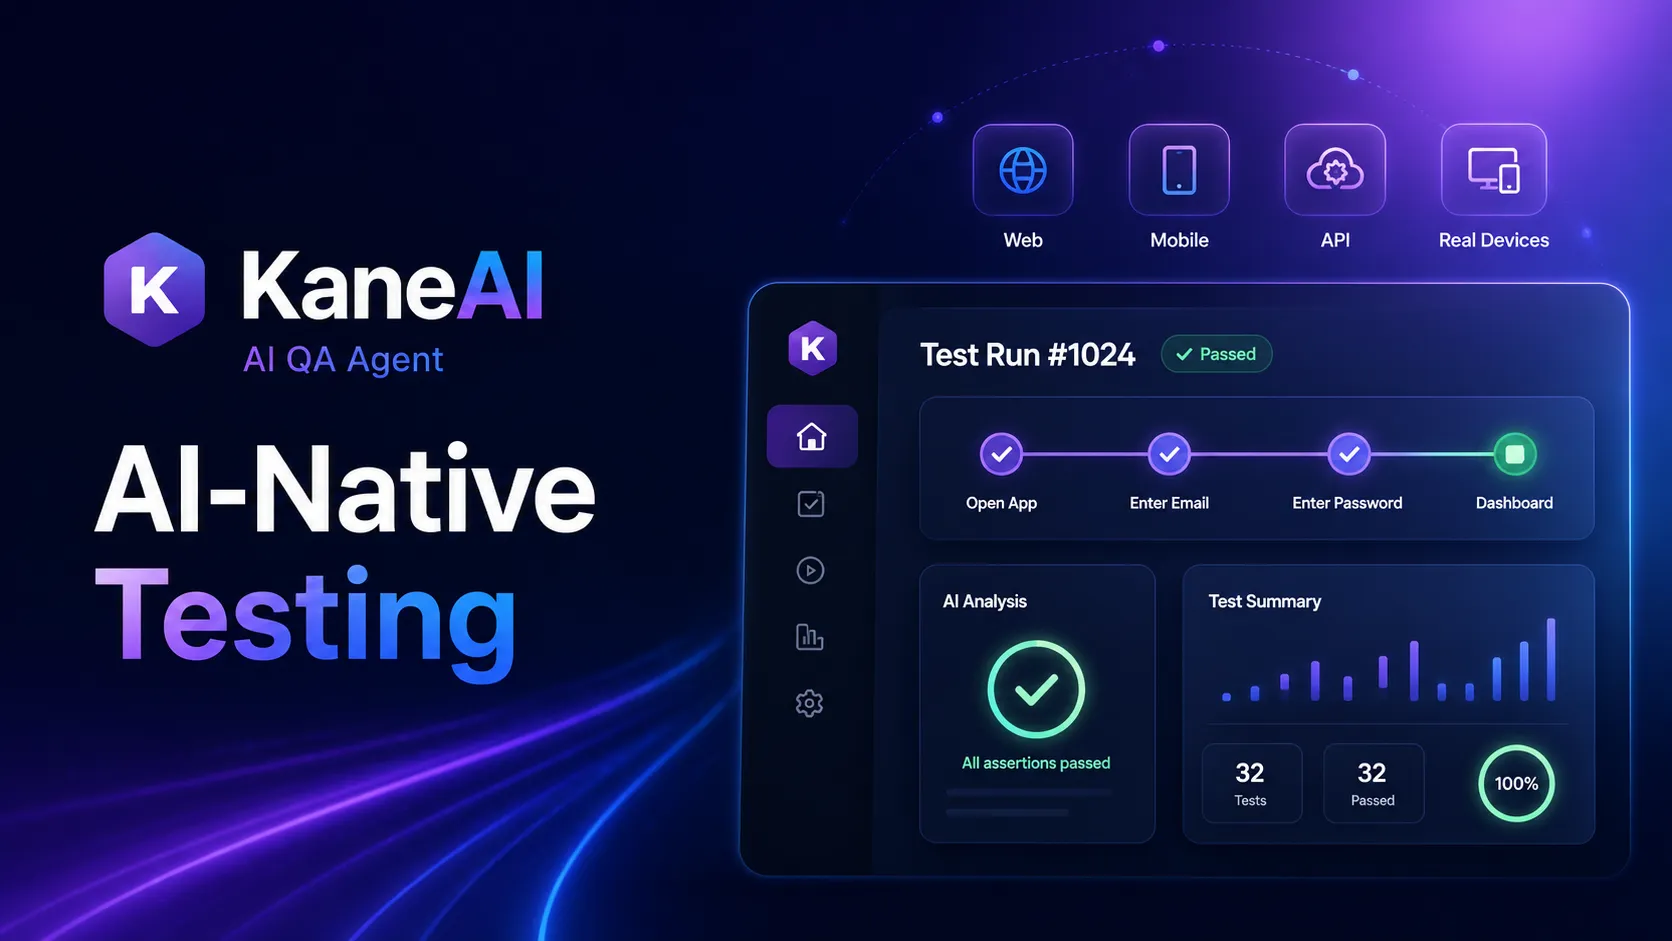
AI QA Agent (KaneAI)
KaneAI 是一款原生 AI 软件 QA 智能体,定位介于传统的脚本化测试自动化与自主式智能体测试平台之间。
资料核对: 2026年8月14日 ·查看来源
工具信息
- 工具类型
- 评审与测试
- 平台
- Browser, CLI
- 免费方案
- 不支持
- 开源
- 不支持
- 自带密钥
- 不支持
- 本地模型
- 不支持
工具概览
适合场景
- 需将产品需求转化为可执行回归覆盖的 QA 团队
- 希望转向自动化但不想从零编写每个测试的人工测试员
- 在快速发布周期中增加自动化 QA 关卡的工程团队
- 需要对 AI 生成的应用变更进行独立验证的“氛围编程”团队
- 需在多种浏览器和设备组合上测试 Web 和移动端路径的组织
- 希望获得 AI 辅助测试同时保留导出传统自动化代码选项的团队
优点
- 减少创建端到端测试所需的手动脚本编写量。
- 将 AI 编写与真实执行相结合,而不只是停留在测试用例建议阶段。
- 同时适用于人工 QA 团队和自动化工程师。
- 框架导出功能提供了回归传统测试代码的路径。
- 适配 CI/CD、Jira 和工程工作流,而非仅仅作为独立的 QA 界面运行。
- 比仅限代码审查的 QA 智能体支持更广泛的 Web 和移动端测试场景。
局限与取舍
- 仅寻求静态代码审查或 PR 评论的团队
- 需要完全自托管或离线 AI 测试栈的项目
- 主要需求是生成单元测试而非应用级 QA 的开发者
- 需要可内部修改的开源 QA 智能体的团队
- 不愿在将 AI 生成的断言设为发布关卡前进行人工评审的组织
- 对于业务关键路径,AI 生成的测试意图和断言仍需人工评审。
- 云端 Web 和移动端编写功能集中在较高价位的方案中。
- 基于额度的计费模式意味着成本取决于团队使用智能体编写和云端执行的频率。
- 属于托管型商业平台,而非开源测试智能体。
- 需要完全离线或自托管 AI 推理的团队需另寻方案。
开始使用
价格与使用额度
付费起价 $19
Starter$19 / 智能体/月
每月 2,000 额度,支持本地 Kane CLI 编写;年付约 17 美元/智能体/月。
Pro$99 / 智能体/月
12,000 额度,支持云端 KaneAI Web 编写,每月包含 100 分钟 HyperExecute 时长。
Max$199 / 智能体/月
25,000 额度,支持云端 KaneAI Web 和移动端编写,每月包含 300 分钟 HyperExecute 时长。
EnterpriseCustom
高业务量部署,提供无限额度、SSO、企业级控制及自定义商务条款。
价格核对: 2026年8月14日 · 额度、模型费用与订阅价格可能分别计算。
功能与详细介绍
AI 测试编写
- 根据自然语言指令创建可执行测试
- 从 PRD、Jira 工单、文档及其他需求生成覆盖
- 构建条件化及可复用的测试流
- 生成结构化断言,无需手动编写每一步测试
执行与维护
- 跨 Web、移动端、API 和真实设备环境运行测试
- 应用界面变更时自动修复元素定位
- 通过 AI 辅助的根因分析工作流分析故障
- 获取执行凭据,包括日志、截图和录屏
开发者工作流
- 将测试集成至 CI/CD 和 Pull Request 工作流
- 与 Jira 和 Azure DevOps 同步测试工作流
- 将自动化脚本导出为 Selenium、Playwright、Cypress 和 Appium 代码
- 使用 Kane CLI 进行终端原生的本地编写
为什么选择 KaneAI 这样的 AI QA 智能体?
当自动化测试本身成为开发瓶颈时,KaneAI 的价值最为突出。虽然 Playwright、Cypress、Selenium 和 Appium 等传统框架功能强大,但每个关键业务路径仍需转化为测试逻辑、断言、固件、定位器和繁琐的维护工作。
AI QA 智能体改变了抽象层级。团队不再从实现细节入手,而是从意图出发:用户应该能完成什么操作、什么结果是正确的、哪些失败条件至关重要。
这种转变对于采用 AI 编程智能体和“氛围编程”(vibe-coding)流转的团队尤为重要。现在应用代码的变更速度远快于手动维护的回归测试套件。独立的 QA 智能体可以作为生成的代码与部署之间的验证层,而不是让同一个编程智能体来审查自己的工作。
需要注意的是,更快的测试创建速度并不意味着可以放弃测试策略。仍需有人决定哪些行为是核心、哪些边缘案例代表真实业务风险,以及看似成功的交互是否真的证明了预期的结果。
核心工作流
实际的 KaneAI 工作流是从需求而非自动化框架开始的。
首先将产品需求、工单、验收标准或发布目标转化为可测试的用户路径。生成的场景在进入长期回归测试库之前应经过人工评审。这一人工审查步骤至关重要,因为 AI 智能体自动化错误需求解读的效率与自动化正确需求的效率一样高。
测试执行通常应针对可预测的开发或预发布环境,并配套专用账号和受控的测试数据。运行失败的结果应作为可复现的缺陷反馈给工程团队,而非模糊的 QA 报告。
对于稳定的场景,将生成的自动化脚本导出或集成到团队现有的 CI 流水线中,可以在测试创建与常规回归执行之间建立有用的隔离。这样可以将 Agent 的推理能力保留在确实能产生价值的场景中,而非用于每一个确定性的步骤。
面向氛围编程(Vibe Coding)的 AI QA
AI 生成的应用带来了一个新问题:产出代码的成本下降速度快于验证代码的成本。
使用 Cursor、Claude Code、Codex 或 Replit Agent 的开发者可以在单次会话中对界面进行多处重大更改。在每次变更后手动检查登录、引导、计费、表单、权限、响应式状态等关键路径,很快就会变得不切实际。
KaneAI 在此工作流中充当第二层验证,而非另一个代码生成器。编程智能体实现功能,QA 智能体则从用户视角操作运行中的产品。这种分离极具价值,因为与已部署应用交互的测试可以暴露集成和行为故障,而这些故障是仅靠对生成的源码进行静态检查无法发现的。
对于氛围编程项目,价值最高的起点通常是一组精简的业务关键路径,而非数百个自动生成的案例。身份验证、注册、结账、订阅变更、破坏性操作和核心转化流程,是比详尽的低风险覆盖更理想的初始质量关卡。
适用场景
KaneAI 非常适合正从手动发布清单转向可重复自动化回归测试的团队。QA 工程师可以用业务语言描述工作流,同时在确定性控制变得重要的地方逐步引入传统自动化。
它也适用于需求驱动开发。工单或产品规格书可以在开发完成前就成为 QA 覆盖的起点,助力测试向开发周期左移,而不是将其留作发布的最后阶段。
另一个强力场景是多环境下的发布候选版(RC)验证。团队只需定义一次重要路径,即可在应用变更时跨多环境进行一致性评估,而无需依赖开发者个人的本地浏览器。
如果测试问题主要集中在单元级的正确性,该产品的吸引力则较弱。主要需要生成 Jest、pytest、JUnit 或类似单元测试的项目,从编程智能体或专用单元测试生成工具中获得的价值可能高于这种面向用户路径的 QA 平台。
竞品对比
Momentic 针对类似的开发者工作流,构建了围绕自然语言端到端测试和 Agent 交互的功能。如果首要任务是将基于 AI 的 E2E 测试与工程流紧密结合,它值得直接对比。
Autify Aximo 是另一个相近的选择。当团队希望 AI 测试员能够自主操作用户界面而无需手动指定每一步交互时,其自主测试方法尤为适用。
从更广泛的成熟测试平台角度来看,mabl 也是竞争对手。已经在考虑组织级测试管理和持续质量工程的团队,应将其 Agent 能力与 KaneAI 进行对比,而非仅评估自然语言生成的质量。
对于对“模仿真实用户行为”而非“传统定位器驱动自动化”的 AI 智能体感兴趣的团队,Spur 具有很强的可比性。实际评估时,应关注各系统处理团队真实应用、鉴权模式、动态界面、测试数据和故障诊断的可靠性,而非通用的 AI 功能堆砌。
最佳实践配置
建议从 10 到 20 条一旦失效就会严重损害业务的核心路径开始。一个精简且可信的测试集比数百个无人审阅的自动生成场景更有价值。
尽可能使用专用测试账号和确定性的种子数据。AI 可以适应界面的变化,但无法补偿在运行之间状态不可预测变化的环境。
断言比动作更值得关注。点击结账很容易,但决定什么能证明结账真正成功才是关键。请明确定义预期的状态变更、持久化记录、确认状态、权限或其他有意义的结果。
将 Agent 的行为保留在确实需要理解和解读的路径部分。稳定的操作可以保持确定性。这种混合方法通常使故障更易复现,并能限制不必要的 AI 消耗。
最后,将生成的自动化脚本视为工程资产。评审重要的测试,对其进行版本管理,将其连接到发布关卡,并定期清理过时的覆盖,不要任由自动生成的套件无限增长。
迁移建议
已经在用 Playwright、Cypress、Selenium 或 Appium 的团队不应假设采用 AI QA 智能体就必须替换现有套件。
一种低风险的迁移策略是保留可靠的既有测试,将 KaneAI 用于新增覆盖、难以维护的工作流、探索性场景或目前仅靠人工测试的需求。在迁移更多覆盖之前,请先衡量维护时间、故障质量、执行稳定性和漏测率。
重复的场景最终应有明确的归口。无限期同时运行旧的脚本流程和新的 AI 编写版本会浪费执行资源,并使故障分析变得复杂。
对于拥有大量人工 QA 职能的组织,采用过程也可以是渐进的。测试员可以先利用智能体将可重复的发布检查形式化,而自动化工程师则负责评审生成的案例并决定哪些工作流应成为永久的 CI 关卡。
总体目标不是用自主智能体取代所有传统测试,而是缩短产品需求与可信自动化检查之间的距离,同时保留足够的人工和确定性控制,确保故障是可修复、可跟进的。
模型支持与数据隐私
隐私与数据处理
KaneAI 是 TestMu AI 托管测试平台的一部分,因此团队应将提示词、测试数据、凭据、截图、录屏等执行产物视为潜在的敏感数据。TestMu AI 提供了企业级安全控制,包括 SSO、RBAC、审计日志、合规控制及数据保留选项;处理受监管或生产数据的组织在部署前应查阅最新的安全与隐私文档。
指南、评测与常见问题
相关指南正在整理中,可以先查看官方文档。
产品动态
暂时没有经过核对的产品动态。关注后,新的相关内容会出现在「我的收藏」。
查看相关内容动态替代工具
Momentic这是一个对代码仓库友好的智能体 QA 平台,能将自然语言意图转化为具有自愈能力的 Web 和移动端测试,并填补 PR 和提交周边的覆盖率空白。 Aximo一款自主的跨应用 AI 测试工具,像真实用户一样验证行为,并能为编程 Agent 提供上下文以生成测试脚本。
 Spur基于浏览器的 AI QA 工具,让产品和工程团队无需手写每个测试脚本,也能快速建立易维护的端到端测试覆盖。
信息来源与核对记录
核对日期记录本站何时检查信息;不代表产品发版日期。
本站资料修订记录
根据当前的 TestMu AI 产品、文档和定价页面核对了价格与产品定位。
针对当前的 Web 测试生成和执行工作流更新了官方 KaneAI Web 测试文档。
LambdaTest 更名为 TestMu AI,KaneAI 继续作为该平台的原生生成式 AI 测试智能体。